 EveryGen AI
 · AI 口型同步:匹配短录音与已有表演
将清楚肖像视频与希望它呈现的录音配对。EveryGen AI 的 AI 口型同步使用 Sync Lip Sync 2 standard,从两个文件生成音频驱动短结果。仔细准备表演与录音,再贯穿全片检查嘴部运动。AI 口型同步从上传语音开始,不使用输入对话或声音生成菜单。
视频工作区
上传一个 MP4/MOV 视频和一个 WAV/M4A 音频文件,两者均须短于 30 秒。积分按音频时长计算。
Pair the portrait with recorded male speech
14/18查看提示词
Prepare the authorized adult woman’s portrait video in MP4 or MOV and the provided male speech recording in WAV or M4A, each shorter than thirty seconds. Keep the face and mouth clearly visible. Load Video Input and Audio Reference, then review the audio-length output for mouth timing, natural facial detail, and any repeated movement from loop mode.
简介
在 EveryGen AI 中给 AI 口型同步清楚声画组合
已有视觉表演需要跟随准备好的录音时,使用 EveryGen AI 的 AI 口型同步。来源视频与音频各有不同作用。
处理前选择信息
使用 EveryGen AI 的 AI 口型同步前,准备一段介绍、修改后说明或获准替代录音。流程使用完成音频,不将书面脚本转为语音。选择有完整结尾的信息。
理解两项必需文件
EveryGen AI 的 AI 口型同步要求一个 MP4 或 MOV 视频,以及一个 WAV 或 M4A 音频,分别短于三十秒。选择一段清楚录音和合适肖像表演。页面不要求逐字稿、语言选择或文字提示词。
让参与者明白用途
使用获准视频与音频,可见人物与声音不同时也一样。EveryGen AI 的 AI 口型同步创建改动后的表演,不是原始发言证据。让参与者清楚预期展示方式。
使用方法
如何在 EveryGen AI 中使用 AI 口型同步
- 输入参考视频 1步骤 1
准备来源组合
给 EveryGen AI 的 AI 口型同步上传一个 MP4 或 MOV 视频,以及一个 WAV 或 M4A 录音,每个短于三十秒。
- 示例设置Sync Lip Sync 2source5s
 输出步骤 2
检查表演
预览 EveryGen AI 的 AI 口型同步输入,确认嘴部可见、语音清楚,肢体运动适合整个录音时长。
- 示意预览
The recording guides mouth movement in an existing video. Listen to the input, then inspect the mouth positions.
步骤 3检查并同步
选择 Sync Lip Sync 2 standard,核对 EveryGen AI 的 AI 口型同步创建报价,不输入文字指令即可处理。
- 步骤 4
检查讲话结果
检查 EveryGen AI 的 AI 口型同步时序、面部细节与循环过渡,确认与音频等长的结果呈现完整信息,再下载。
功能
选择嘴部可读的 AI 口型同步片段
录音播放时脸部需要始终易懂。给 EveryGen AI 的 AI 口型同步适合可见讲话的来源,避免反复遮挡或突然剪切。
选择稳定面部视角
选择大致正面或稍倾斜、嘴部可读的脸。EveryGen AI 的 AI 口型同步来源若以快速转头或极端侧脸为主,会更难检查。优先嘴唇与下颌可见的稳定表演。
- 使用 EveryGen AI 时,让嘴部在预期观看尺寸足够大,便于判断。
- 在 EveryGen AI 中预览 AI 口型同步来源的每次头部运动。
避免可避免的遮挡
手、麦克风、围巾或穿过嘴部的物体,会遮住需要检查的区域。在 EveryGen AI 的 AI 口型同步中选择相关特征始终可见的片段。有多个来源时,优先少中断版本,而非最复杂运镜。
画面中保持一个明确讲述者
页面没有脸部区域选择控件。为 EveryGen AI 的 AI 口型同步准备聚焦目标成人讲述者的片段,不依赖不存在的选择工具。检查全片,避免重要录音刚开始时主体消失。
给 AI 口型同步完成的录音
上传音频建立讲话内容与节奏。生成前为 EveryGen AI 的 AI 口型同步准备好录音,不期待页面改写或演绎它。
录制简洁完整信息
选择能在支持时长内自然结束的一句或短段。使用 EveryGen AI 的 AI 口型同步前聆听,确认开头与最后文字完整。完整表演比突然中断录音更容易判断。
- 使用 EveryGen AI 时,提供一个语音清楚可听的 WAV 或 M4A。
- 让 EveryGen AI 的 AI 口型同步来源音频短于三十秒。
减少来源干扰
选择讲话不被音乐、另一人或房间噪声淹没的录音。EveryGen AI 的 AI 口型同步在此并非音频清理流程。更清楚录音,让可见口部动作与听众实际听到的内容有更好比较基础。
上传前完成停顿安排
过长开头静音或不必要尾音会改变结果需要的画面时间。使用 EveryGen AI 的 AI 口型同步前,在自己的音频流程修剪这些部分,同时保留自然呼吸与句间停顿。不移除赋予讲话含义的节奏。
围绕音频时长规划 AI 口型同步
EveryGen AI 的 AI 口型同步为准备好的录音使用配置的 loop 模式。围绕音频规划视觉来源,再检查结果时长与重复动作。
先比较两个时长
检查录音比可见来源表演短还是长。EveryGen AI 的 AI 口型同步需要覆盖超过一遍来源视频的音频时,视觉重复可能明显。选择适合完整信息的来源动作。
- 使用 EveryGen AI 时,预览所选视觉来源并听完整录音。
- 检查 EveryGen AI 的 AI 口型同步中手势回到起点的循环过渡。
优先可重复肢体语言
平静姿势比戏剧性手势后离开画面更易复用。在 EveryGen AI 的 AI 口型同步中选择肢体语言适合完整录音的片段,再检查重复运动是否分散对后续文字的注意。
让录音定义结尾
EveryGen AI 的 AI 口型同步发送来源视频与上传录音,并选择 loop 模式。按音频时长规划信息,再核对实际返回时长,不假定原视频长度不变。保持最终句完整,检查结束有无突然切断或干扰重复。
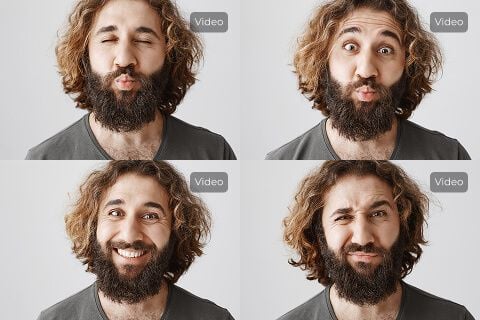
按实际文件控件使用 AI 口型同步
将准备与处理分开。EveryGen AI 的 AI 口型同步使用来源视频和音频参考输入,不需要一段场景指令。
选择已核对流程
选择 Sync Lip Sync 2 standard,把准备好的文件放进对应输入。EveryGen AI 的 AI 口型同步在此不提供文字转语音字段或语言菜单。上传录音提供待处理讲话表演,而非输入的语言选项。
把示例当作素材简报
示例卡描述待准备或加载素材,不是 EveryGen AI 的 AI 口型同步文字命令。选择清楚脸部与合适录音,再预览实际文件。合适示例描述不能弥补上传错版本。一至四个输出是独立处理候选,不是自动机位或完成序列。没有独立比例或原生音频开关。
核对当前创建报价
实际媒体时长影响处理报价。加载目标 EveryGen AI 的 AI 口型同步文件后检查创建报价,不依赖固定积分数字。更换录音后,再次提交前重查时长与报价。
按正常播放速度评价 AI 口型同步
不只看一个可信嘴形。EveryGen AI 的 AI 口型同步检查应覆盖整句时序、面部外观、重复运动与最终停顿。
看讲话起止
按正常速度播放结果,留意嘴部活动是否随录音开始和停稳。先看整体,再在可疑时刻暂停。EveryGen AI 的 AI 口型同步可能静帧合理,连续口部动作却显得早、晚或过于繁忙。
检查牙齿与面部边界
讲话时查看嘴唇、牙齿、下颌和脸颊周围。EveryGen AI 的 AI 口型同步即使时序可接受,也可能引入重要视觉变化。将这些特征与来源比较,检查脸部在不同声音中是否仍自然。
按需修改输入
配对仍分散注意时,选择更好视觉版本,或在外部调整录音。EveryGen AI 的 AI 口型同步没有文字修复控件。保存原文件与批准输出,方便合作者比较后续版本。提交前登录并确保积分足够。上传与结果保存到账户,处理需要网络和云端提供方。按实际文件核对当前报价。
示例提示词
Material preparation: portrait video and recorded speech
Prepare an authorized adult portrait video in MP4 or MOV and one clear WAV or M4A speech recording, both shorter than thirty seconds. Keep the mouth visible and choose modest head movement. Load the files into Video Input and Audio Reference, then review timing and any repeated visual movement in the result.
Material preparation: a complete short introduction
Choose a portrait video with a calm, repeatable posture and record one complete short introduction as WAV or M4A. Leave natural sentence pauses while removing unnecessary leading silence in your own audio editor. Keep both files below thirty seconds. Review the final audio-length performance for clear articulation and a natural ending.
工作流示例
规划、生成和检查作品的示例场景。
EveryGen AI 工作流示例
从产品照片和明确的图片编辑要求开始。将初稿与原图比较,核对外形、标签和比例,再放入商品页面。在设计应用中补上已经确认的标志和准确文案。
选择视频模型,描述一个小动作,例如物体缓缓转动。核对可用时长、分辨率和积分。把镜头用于后续剪辑前,检查物体连续性和声音。
为图片工作区说明主体、视角和支持文章主题的视觉隐喻。在目标版式中预览结果。若图片抢占标题的注意力或遮挡重要细节,调整裁剪或构图。
图片尺寸合适但文件偏大时,登录后使用图片压缩工具。压缩在浏览器中完成,输入和结果会保存到你的账户。下载单张图片或 ZIP 前先比较结果。
把草稿粘贴到 Humanize AI,选择自然、亲切或专业语气。核对改写后的含义、名称、数字和技术术语,再复制或下载已经检查的版本;检测分数和发表结果没有保证。
将配色、视角、光线和主体尺度记录在可复用的创作说明中。所选图片模型支持参考图时,提供相关素材。把图片放在一起比较,针对差异修改,不假设整个系列会自动保持一致。
EveryGen AI · MiniMax H3 Max 价格与积分套餐
随时取消
Lite
50%折扣0.025/积分
每年计费$179· 节省$179.8
视频模型


图像模型


- 包含 MiniMax H3 及所有高级模型
- 最多1个批量生成任务
- 标准生成速度
- 标准生成成功率
- 标准客户支持
- 商业使用许可
Standard
50%折扣0.017/积分
每年计费$299· 节省$299.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多4个批量生成任务
- 优先处理速度
- 高生成成功率
- 优先客户支持
- 商业使用许可
Pro
50%折扣0.014/积分
每年计费$599· 节省$599.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
Max
50%折扣0.012/积分
每年计费$1,199· 节省$1,199.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
通过以下方式安全支付





常见问题
常见问题
AI 口型同步会把书面脚本变成讲话吗?
EveryGen AI 的 AI 口型同步不会。请准备并上传 WAV 或 M4A 录音。本页没有文字转语音、输入提示词或语言选择控件。来源音频提供信息和节奏。
AI 口型同步接受哪些文件?
EveryGen AI 的 AI 口型同步使用一个 MP4 或 MOV 视频,以及一个 WAV 或 M4A 音频,每个都必须短于三十秒。选择清楚可见讲述者与完成录音,不用很长无关片段序列。
什么决定 AI 口型同步输出时长?
此 loop 配置中,上传音频决定 EveryGen AI 的 AI 口型同步输出时长。录音超过一遍来源表演时,检查视觉重复。不假定原视频长度就是最终时长。
AI 口型同步能在合照视频中选择脸部吗?
EveryGen AI 的 AI 口型同步界面没有脸部区域选择控件。选择聚焦目标成人讲述者的来源片段。让嘴部贯穿表演可见,不依赖页面不接受的指令。
AI 口型同步保证精确嘴部时序吗?
EveryGen AI 的 AI 口型同步不保证精确对齐或面部外观不变。带声音观看完整结果,检查句子开头、停顿和嘴部区域。遮挡或不合适手势妨碍表演时,选择更好的来源组合。
行动入口
用 EveryGen AI 的 AI 口型同步匹配准备好的录音
为 EveryGen AI 的 AI 口型同步选择清楚肖像表演与完成录音,核对创建报价,再处理组合。带声音看完整信息,选择要分享的版本。
同步录好的语音