 EveryGen AI
 AI 音乐视频生成:用短场景回应音乐
让叶片缓缓漂过倒影,或让平静运镜展现景深。EveryGen AI 的 AI 音乐视频生成使用 MiniMax H3 Multi Reference 模式,以图片或视频配合可选音频指导。初始 2K、五秒和自适应构图,先评估视觉段落,再将它安排进更完整的音乐序列。
视频工作区
A quiet illustrated cafe at dusk
13/18查看提示词
Use @Image 1, the illustration of a man holding a book in a cafe at dusk. Create a slow five-second camera push with warm window light, a small natural shift of his gaze toward the book, and restrained background movement. Retain the illustration style, seated pose, book, table, and cafe arrangement, keeping the scene calm and continuous.
简介
给 AI 音乐视频生成一个短视觉任务
给 EveryGen AI 的 AI 音乐视频生成一种氛围或视觉变化来探索,不要让它自动为整首歌曲配画面。
用可见细节说明感受
安静段落可能对应倒影上缓慢移动的叶片;更强段落可能对应果断的摄影机靠近。告诉 EveryGen AI 的 AI 音乐视频生成,观众应该看到什么。
从图片或视频开始
提供至少一份视觉参考。EveryGen AI 的 AI 音乐视频生成将图片或视频与获授权音频结合,不支持只有音频。选择适合音乐方向的场景,不要仅为满足输入要求加一张无关图片。
使用短生成时窗
EveryGen AI 的 AI 音乐视频生成初始 H3 Multi Reference、2K、五秒和自适应构图。可选五至十五秒整数时长、适用的固定比例及一至四个候选。用分别审阅的段落构建长序列;一个请求不会安排整首歌曲。
使用方法
如何使用 EveryGen AI 的 AI 音乐视频生成
- 输入
 参考图片 1步骤 1
选择视觉与音频参考
在 EveryGen AI 的 AI 音乐视频生成中选择 MiniMax H3 参考模式,上传图片或视频,适用时添加获授权音频。
- 示例设置MiniMax H32K5s提示词输出步骤 2
描述视觉回应
告诉 EveryGen AI 的 AI 音乐视频生成,所供场景应怎样运动和传达感受,给视觉与音频参考明确角色。
- 示意预览
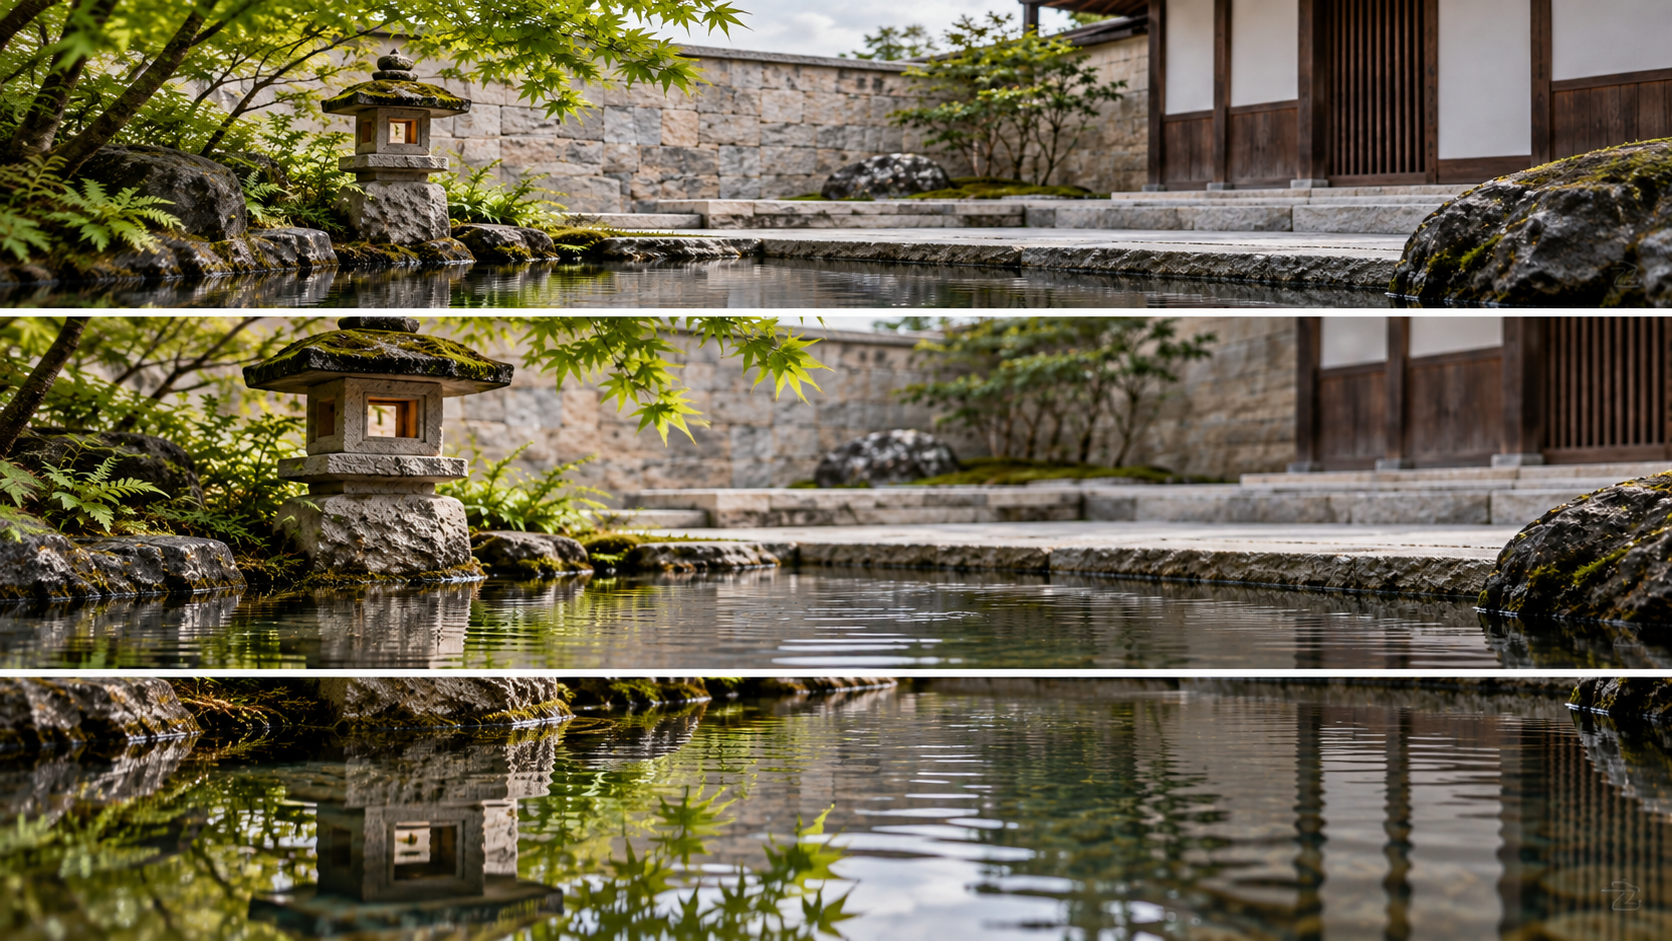
音乐营造氛围,镜头缓缓向水面靠近。
步骤 3生成一个短场景
让 EveryGen AI 的 AI 音乐视频生成从五秒、2K 开始,审阅显示积分,再生成聚焦视觉段落。
- 步骤 4
比较情绪与动作
一起观看 EveryGen AI 的 AI 音乐视频生成动作与声音,修改最弱关系,再下载片段用于独立编辑流程。
功能
为 AI 音乐视频生成参考指定明确用途
告诉 EveryGen AI 的 AI 音乐视频生成,哪份参考提供场景、哪份指导动作、哪份贡献音乐氛围。
选择视觉锚点
用图片提供有意安排的构图,或用视频提供已有主体和动作。向 EveryGen AI 的 AI 音乐视频生成解释其角色。强有力锚点让场景联系你的项目,辅助参考只贡献你需要的特质。
- 让 EveryGen AI 的视觉锚点中主要主体清晰可读。
- 给 EveryGen AI 的 AI 音乐视频生成一个主要场景来发展。
描述音频贡献什么
向 EveryGen AI 的 AI 音乐视频生成说明,音频暗示持续氛围还是更鲜明能量变化。这里 H3 参考模式没有原生音频开关。上传声音用于指导,不保证原声轨原样转移或精确卡点;应检查返回画面及随附音频。
避免参考集合拥挤
在 EveryGen AI 的 AI 音乐视频生成中,最多使用九张图片、三个视频和三个音频文件,总计十二份。至少需要一张图片或一个视频,只有音频不能启动场景。只有能回答具体视觉或氛围问题时才添加参考。
描述 AI 音乐视频生成动作,避免精确节拍承诺
给 EveryGen AI 的 AI 音乐视频生成可观察的节奏和清晰进程,让片段即使没有精确音乐同步也有用。
选择一种动作质感
慢慢漂移、轻轻摇摆或有目的的前移,可分别适合不同段落。让 EveryGen AI 的 AI 音乐视频生成采用一种主要动作质感。躁动主体、平静摄影机与无关效果混合,可能削弱预期音乐氛围。
- 在 EveryGen AI 简报中清楚描述速度、分量感与方向。
- 让 EveryGen AI 的 AI 音乐视频生成动作易读,不依赖复杂编舞。
创建小幅视觉进程
场景可以从静止开始,发展一个动作,再随光线倒影消退而平静下来。向 EveryGen AI 的 AI 音乐视频生成解释这个顺序。
让来源决定物理范围
静态风景适合树叶运动或克制运镜;已有表演素材可指导较大手势。让 EveryGen AI 的 AI 音乐视频生成指令符合所供材料。要求紧裁静态图产生戏剧动作,可能需要凭空补出过多结构。
通过画面选择建立 AI 音乐视频生成氛围
在 EveryGen AI 的 AI 音乐视频生成中,用光线、颜色与景深表达音乐氛围,避免让无关效果填满镜头。
为配色分清主次
选择一种主色和符合来源的小面积强调色。柔和绿色环境配暖色倒影,与明亮且均匀饱和的颜色传达不同感受。给 EveryGen AI 的 AI 音乐视频生成这种关系,让氛围发展时焦点仍清晰。
- 把 EveryGen AI 场景中的明亮点缀联系到可见物体。
- 检查 EveryGen AI 的 AI 音乐视频生成整段镜头中的颜色变化。
用景深支持摄影机
前景边缘、主体区域与安静远景,能为轻微运镜创造空间。告诉 EveryGen AI 的 AI 音乐视频生成哪一层最重要。
让效果联系场景
柔光可对应已有灯具,涟漪应出现在可见水面。要求 EveryGen AI 的 AI 音乐视频生成使用基于参考的效果。没有缘由的闪光与悬浮装饰,可能分散对音乐的注意,无法把其特质转成连贯画面。
把 AI 音乐视频生成场景发展成视觉系列
把 EveryGen AI 的每个 AI 音乐视频生成输出,规划为独立拼接序列中承担具体角色的镜头。
让不同镜头承担不同角色
交代环境的广角、较近的手势和平静结尾,提供有用变化。围绕合适视觉来源准备 EveryGen AI 的每次 AI 音乐视频生成请求。比起制作几个几乎一样片段、事后希望形成故事,这能产生更有目的的材料。
记录重复细节
为相关镜头记录配色、主体描述、光线与偏好运镜。在 EveryGen AI 的 AI 音乐视频生成中复用这些选择,再比较实际结果。共同简报可以指导连贯性,不能保证不同请求的人脸、服装或景物完全相同。
留待后续作最终剪辑决策
把标题、歌词、精确音频位置和转场留在独立编辑流程。EveryGen AI 的 AI 音乐视频生成不是时间线或字幕引擎。干净场景与稳定结尾,比烧录不准确文字更便于后续安排。
一起审阅 EveryGen AI 的 AI 音乐视频生成画面与声音
评估 EveryGen AI 的 AI 音乐视频生成画面、节奏和声音,是否在完整短场景中支持同一种氛围。
静音观看场景
静音检查动作与进程。EveryGen AI 的 AI 音乐视频生成输出应独立具有视觉意义。依靠音乐让混乱场景显得有意义前,先检查主体细节、透视与意外物体。
试听实际关系
把返回画面及随附声音与预期能量比较。EveryGen AI 的 AI 音乐视频生成不保证精确卡点或完全复现参考音频。评估实际收到结果,特别是与目标氛围竞争的意外讲话或声音。
修改最明确的不匹配
选择一个修正,如较慢摄影机或较简单配色。登录并确保积分足够,云端处理前检查 EveryGen AI 的 AI 音乐视频生成当前报价。H3 需要提示词,最多 7,000 字符。输入与结果保存到账户;保留选定来源分工,供后续序列制作使用。
示例提示词
A still image responds to the supplied audio
Use @Image 1 as the scene and composition reference. Use @Audio 1 to guide the overall musical atmosphere, not exact beat timing. Generate a five-second scene with one gentle camera move and restrained motion in existing environmental details. Keep the main subject recognizable and the palette coherent. Begin quietly and finish with a brief settled moment. No lyrics, captions, new subjects, or scene cuts.
A music-led variation of existing footage
Use @Video 1 for the main subject, setting, and basic motion. Let @Audio 1 guide a calmer, more flowing interpretation of that movement. Create one five-second scene with smooth camera behavior and minimal background distraction. Aim to retain the source subject and visual relationships. No extra performance actions, written lyrics, or abrupt cuts; exact soundtrack reproduction is not required.
工作流示例
规划、生成和检查作品的示例场景。
EveryGen AI 工作流示例
从产品照片和明确的图片编辑要求开始。将初稿与原图比较,核对外形、标签和比例,再放入商品页面。在设计应用中补上已经确认的标志和准确文案。
选择视频模型,描述一个小动作,例如物体缓缓转动。核对可用时长、分辨率和积分。把镜头用于后续剪辑前,检查物体连续性和声音。
为图片工作区说明主体、视角和支持文章主题的视觉隐喻。在目标版式中预览结果。若图片抢占标题的注意力或遮挡重要细节,调整裁剪或构图。
图片尺寸合适但文件偏大时,登录后使用图片压缩工具。压缩在浏览器中完成,输入和结果会保存到你的账户。下载单张图片或 ZIP 前先比较结果。
把草稿粘贴到 Humanize AI,选择自然、亲切或专业语气。核对改写后的含义、名称、数字和技术术语,再复制或下载已经检查的版本;检测分数和发表结果没有保证。
将配色、视角、光线和主体尺度记录在可复用的创作说明中。所选图片模型支持参考图时,提供相关素材。把图片放在一起比较,针对差异修改,不假设整个系列会自动保持一致。
EveryGen AI · MiniMax H3 Max 价格与积分套餐
随时取消
Lite
50%折扣0.025/积分
每年计费$179· 节省$179.8
视频模型


图像模型


- 包含 MiniMax H3 及所有高级模型
- 最多1个批量生成任务
- 标准生成速度
- 标准生成成功率
- 标准客户支持
- 商业使用许可
Standard
50%折扣0.017/积分
每年计费$299· 节省$299.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多4个批量生成任务
- 优先处理速度
- 高生成成功率
- 优先客户支持
- 商业使用许可
Pro
50%折扣0.014/积分
每年计费$599· 节省$599.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
Max
50%折扣0.012/积分
每年计费$1,199· 节省$1,199.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
通过以下方式安全支付





常见问题
常见问题
AI 音乐视频生成可以只用音频吗?
给 EveryGen AI 的 AI 音乐视频生成至少一张图片或一个视频。音频可指导氛围,不能替代必需视觉来源。选择支持音乐方向的构图,例如用风景表现环境缓动,不要只为满足输入要求添加无关图片。
AI 音乐视频生成会自动制作整首歌曲吗?
EveryGen AI 的 AI 音乐视频生成制作独立五至十五秒场景,初始五秒、2K。可选一至四个候选,审阅每段演绎,再安排长序列。没有自动歌曲长度时间线、歌词字幕引擎或完整音乐视频拼装;这些决策由自己的编辑器处理。
可以让每个动作对齐节拍吗?
EveryGen AI 的 AI 音乐视频生成不保证精确节拍匹配。描述可见速度、动作方向和稳定结尾,再检查结果。这里 H3 参考模式没有原生音频开关。手势必须对准某个音乐瞬间时,另行控制精确同步与音轨位置。
可以结合已有片段与音乐参考吗?
给 EveryGen AI 的 AI 音乐视频生成获授权视频,提供主体或动作;用音频提供音乐方向。明确解释两者角色。输出是新演绎,不保证帧不变或原声轨复现;放入序列前比较返回场景及随附声音。
能包含多少文件?
EveryGen AI 的 AI 音乐视频生成接受最多九张图片、三个视频、三个音频,总计十二份,且至少一份视觉文件。以最小有用集合开始并标明各自角色。更多参考不能确保连贯性、精确卡点或不同请求间人脸一致。
行动入口
给 EveryGen AI 的 AI 音乐视频生成一个视觉段落
为一个段落选择视觉锚点与清楚音乐氛围。在 EveryGen AI 审阅 AI 音乐视频生成参考、设置与显示积分,再比较画面及随附声音,之后下载片段用于更完整序列。
创建受音乐启发的场景