 EveryGen AI
 · AI 照片说话:让肖像呈现录好的信息
将选中肖像与短录音组合为说话视觉。EveryGen AI 的 AI 照片说话使用 Sync Talking Photo,输入一张图片和一个 WAV 或 M4A 音频文件。录音提供信息及其时长。围绕清楚脸部和完整想法准备素材,分享前检查动画结果。
视频工作区
上传一张肖像图片和一个短于 30 秒的 WAV/M4A 音频文件。积分按音频时长计算。
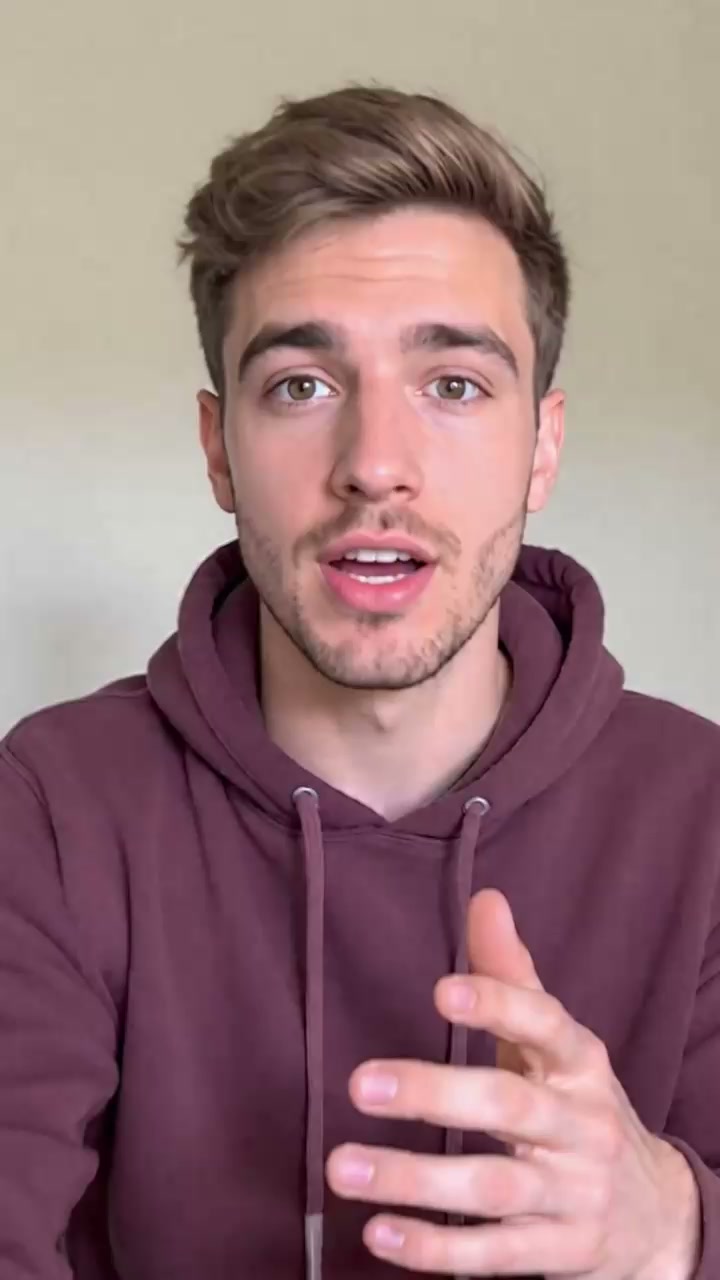
Prepare the portrait and matching voice recording
17/18查看提示词
Prepare the adult man’s authorized portrait image and the provided recording of the same man speaking. Use one WAV or M4A file shorter than thirty seconds, with clear speech and a complete ending. Load the image and audio, then review the generated speaking portrait for recognizable features, natural articulation, comfortable framing, and the full recorded message.
简介
在 EveryGen AI 中给 AI 照片说话一个发言理由
EveryGen AI 中有用的 AI 照片说话任务,会将肖像与短信息联系,例如介绍、欢迎词,或适合由可见讲述者呈现的说明。
从一个完整想法开始
欢迎词或简短介绍,比几个无关要点更集中。使用 EveryGen AI 的 AI 照片说话前先准备信息。选择确实想让人听到的文字,不因仍有时间就延长录音。
使用两项必需材料
上传一张图片,以及一个短于三十秒的 WAV 或 M4A 音频文件。EveryGen AI 的 AI 照片说话通过 Sync Talking Photo 直接使用这些素材。不需要已有肖像视频,页面也没有提示词框或文字转语音字段。
明确肖像作用
使用虚构主体,或获准肖像与录音。EveryGen AI 的 AI 照片说话创建动画展示,不是真实录像证据。取得批准或展示成品时,说明其用途。
使用方法
如何在 EveryGen AI 中创建 AI 照片说话
- 输入
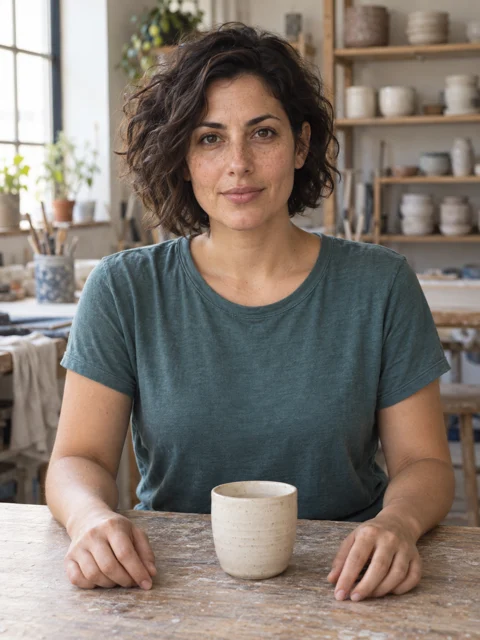 参考图片 1步骤 1
选择肖像
为 EveryGen AI 的 AI 照片说话上传一张清楚、获准肖像,让脸部可见,头肩周围空间舒服。
- 模型Sync Talking Photo5s输出步骤 2
添加录音
为 EveryGen AI 的 AI 照片说话提供一个完成的 WAV 或 M4A,短于三十秒,语音清楚、停顿自然。
- 首帧尾帧
 0.0s
 2.8s
 5.0s步骤 3
检查并创建
选择 Sync Talking Photo,根据已加载录音核对 EveryGen AI 的 AI 照片说话创建报价,不输入文字提示词即可生成。
- 步骤 4
观看并批准
检查 EveryGen AI 的 AI 照片说话口部动作、面部外观和与音频等长的完整信息,再下载批准版本用于目标布局。
功能
为 AI 照片说话准备脸部清晰的图片
按说话任务选择图片,不只看照片是否有戏剧感。EveryGen AI 的 AI 照片说话需要在目标布局中容易检查的脸部。
让面部特征可见
大致正面、眼睛与嘴部清楚的肖像,有助于检查。避免在 EveryGen AI 的 AI 照片说话中选择嘴唇被手、头发或物体遮住的来源。强阴影也可能掩盖需要判断的细节。
- 使用 EveryGen AI 时,选择一个清楚主体,而非繁忙合照。
- 将 EveryGen AI 的 AI 照片说话来源放在生成结果旁比较。
在头部周围留空间
过紧裁切可能让动画运动拥挤。为 EveryGen AI 的 AI 照片说话准备图片时,在发顶和肩部周围留自然空间。在预期布局中检查来源,尤其之后要使用圆形框或窄卡片时。
优先可信来源细节
选择面部细节可读的图片,而非滤镜过重的肖像。EveryGen AI 的 AI 照片说话不能把缺失信息确立为事实。清楚来源有助于判断动画脸部是否仍可辨,而非仅看起来平滑。
给 AI 照片说话一段完成的录音
录音提供实际讲话内容。在 EveryGen AI 上传 AI 照片说话音频前准备好,让预期措辞、语气与停顿已经包含在文件中。
以舒服速度讲话
录制一个简洁信息,短语之间留足自然间隔。EveryGen AI 的 AI 照片说话即使字词可听清,仓促录音也可能让展示难以理解。先不看图片听一遍,独立判断录音。
- 使用 EveryGen AI 时,提供支持的 WAV 或 M4A,时长低于三十秒。
- 让 EveryGen AI 的 AI 照片说话语音避开其他讲话和响亮背景音乐。
保留完整开头与结尾
避免切掉单词第一个声音,或在最后辅音前立即结束。为 EveryGen AI 的 AI 照片说话准备完整开场与自然收尾。短停顿可支持信息,不必要静音则占用时间而不增加有用内容。
处理前选定最终录音
在自己的录音流程修改措辞,再上传选中版本。EveryGen AI 的 AI 照片说话不提供用于修改语音的文字脚本或声音选择器。所提供文件应已表达希望肖像传达的信息。
按最终用途规划 AI 照片说话构图
说话肖像需要合适展示位置。围绕观众观看尺寸及脸部周围信息,为 EveryGen AI 的 AI 照片说话规划构图。
让脸部足够大
肖像在繁忙布局中过小,会削弱表情价值。按预期展示尺寸预览 EveryGen AI 的 AI 照片说话来源。眼睛与嘴部应可读,同时不迫使观众忽略演示或页面其他部分。
- 使用 EveryGen AI 时,为另行添加的标题留清楚空间。
- 确定来源裁切前,检查 EveryGen AI 的 AI 照片说话构图。
使用服务讲话的背景
安静背景让注意留在脸与录音上。在 EveryGen AI 的 AI 照片说话中选择环境适合信息的图片,避免暗示无关工作地点或事件。这里没有场景提示词,因此必需的来源图修改应在说话照片流程前完成。
不围绕身体编舞设计任务
此流程使用图片和录好语音,不使用文字动作或镜头指令。为 EveryGen AI 的 AI 照片说话选择适合作讲话肖像的来源。避免让复杂手部动作成为信息必需条件。
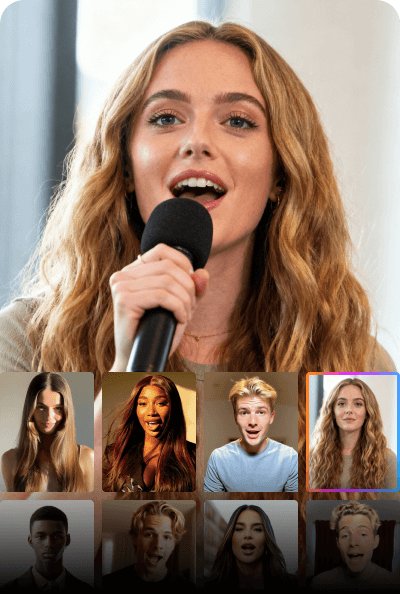
用准备好的素材运行 AI 照片说话
EveryGen AI 的 AI 照片说话任务由文件驱动。开始前一起检查选中图片和音频,再按实际录音核对当前报价。
加载目标组合
选择 Sync Talking Photo,加载最终肖像和获准录音。提交前预览 EveryGen AI 的两项 AI 照片说话输入。相似文件名不能证明选对裁切或音频版本。
让录音确定时长
围绕录音规划 EveryGen AI 的 AI 照片说话结果,处理后核对完整时长。音频应低于三十秒,且结束短语完整。简短欢迎无需静音来凑特定时长。检查下载是否缺开头声音、截断结尾文字,以及表情是否自然停稳。一至四个输出是独立处理候选,不是自动机位或完成序列。没有独立画面比例或原生音频开关。
加载音频后读取报价
时长影响任务成本,因此实际素材就位后,检查 EveryGen AI 的 AI 照片说话创建报价。示例卡提供素材准备想法,不是提交给模型的文字命令。更换录音后,再次提交前重新检查内容、时长和报价。
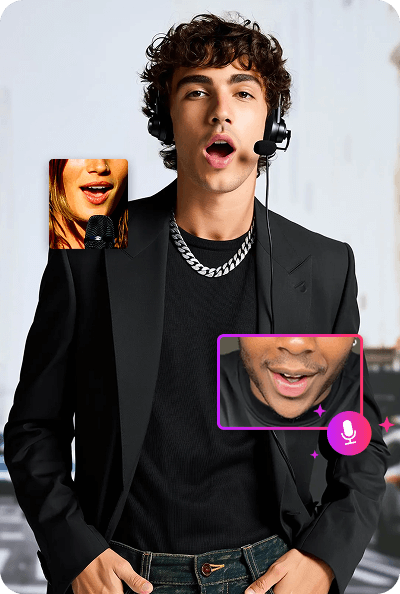
检查 AI 照片说话表情与口部动作
带声音观看完整信息。EveryGen AI 的 AI 照片说话检查应评估肖像是否自然传达,而不只是嘴是否在动。
将脸部与来源比较
肖像讲话时检查眼睛、脸颊、嘴、下颌和头发。EveryGen AI 的 AI 照片说话结果可能引入外观或表情变化。检查时让原图可见,以选中图像为相似度参考,而非依赖模糊记忆。
边听边看讲话展开
留意可见口部动作是否符合录音节奏,并在停顿时稳定。先正常速度检查 EveryGen AI 的 AI 照片说话,再看个别时刻。合理静帧不保证讲话可信,尤其牙齿、嘴唇或表情在声音间突然变化时。
批准实际交付文件
在预期布局中播放下载的 EveryGen AI 的 AI 照片说话结果,检查开场、结尾文字与裁切。将获准图片、音频和输出放在一起。修订时改善该组合;这里没有提示词字段。提交前登录并确保积分足够。上传与结果保存到账户,处理需要网络和云端提供方。按实际文件核对当前报价。
示例提示词
Material preparation: a personal introduction
Prepare one clear authorized adult portrait and a WAV or M4A recording of that person delivering a short introduction. Keep the recording below thirty seconds, with a complete opening and closing sentence. Load the image and audio together, then review the animated face and spoken pacing in the generated result.
Material preparation: a short welcome
Choose a portrait with visible eyes and mouth, a calm expression, and comfortable shoulder space. Record a concise welcome in a quiet environment as WAV or M4A, keeping it shorter than thirty seconds. Finalize the audio before uploading, then inspect the delivered speaking portrait in the layout where it will appear.
工作流示例
规划、生成和检查作品的示例场景。
EveryGen AI 工作流示例
从产品照片和明确的图片编辑要求开始。将初稿与原图比较,核对外形、标签和比例,再放入商品页面。在设计应用中补上已经确认的标志和准确文案。
选择视频模型,描述一个小动作,例如物体缓缓转动。核对可用时长、分辨率和积分。把镜头用于后续剪辑前,检查物体连续性和声音。
为图片工作区说明主体、视角和支持文章主题的视觉隐喻。在目标版式中预览结果。若图片抢占标题的注意力或遮挡重要细节,调整裁剪或构图。
图片尺寸合适但文件偏大时,登录后使用图片压缩工具。压缩在浏览器中完成,输入和结果会保存到你的账户。下载单张图片或 ZIP 前先比较结果。
把草稿粘贴到 Humanize AI,选择自然、亲切或专业语气。核对改写后的含义、名称、数字和技术术语,再复制或下载已经检查的版本;检测分数和发表结果没有保证。
将配色、视角、光线和主体尺度记录在可复用的创作说明中。所选图片模型支持参考图时,提供相关素材。把图片放在一起比较,针对差异修改,不假设整个系列会自动保持一致。
EveryGen AI · MiniMax H3 Max 价格与积分套餐
随时取消
Lite
50%折扣0.025/积分
每年计费$179· 节省$179.8
视频模型


图像模型


- 包含 MiniMax H3 及所有高级模型
- 最多1个批量生成任务
- 标准生成速度
- 标准生成成功率
- 标准客户支持
- 商业使用许可
Standard
50%折扣0.017/积分
每年计费$299· 节省$299.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多4个批量生成任务
- 优先处理速度
- 高生成成功率
- 优先客户支持
- 商业使用许可
Pro
50%折扣0.014/积分
每年计费$599· 节省$599.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
Max
50%折扣0.012/积分
每年计费$1,199· 节省$1,199.8
视频模型
图像模型
- 包含 MiniMax H3 及所有高级模型
- 最多10个批量生成任务
- 最快生成速度
- 高生成成功率
- 专属客户经理
- 商业使用许可
通过以下方式安全支付





常见问题
常见问题
AI 照片说话需要视频输入吗?
EveryGen AI 的 AI 照片说话不需要。上传一张图片和一个支持的录音,肖像提供视觉起点。任务从已有移动肖像视频开始时,使用独立口型同步流程。
AI 照片说话能朗读我输入的文字吗?
EveryGen AI 的本页 AI 照片说话不提供此功能。上传前将语音准备为 WAV 或 M4A。没有提示词输入、文字转语音字段或声音生成控件;录音应已包含所需文字和表达。
AI 照片说话结果有多长?
EveryGen AI 的 AI 照片说话结果跟随音频时长,上传录音必须短于三十秒。自然结束信息,避免不必要静音。用实际录音检查创建报价,因为时长影响成本。
AI 照片说话接受哪些音频格式?
EveryGen AI 的 AI 照片说话使用 WAV 或 M4A。选择包含预期信息与速度的一段清楚录音。其他格式需转换时,在自己的流程中先准备支持文件,再上传。
AI 照片说话会保留全部面部细节吗?
EveryGen AI 的 AI 照片说话不保证精确相似度或口部动作。贯穿录音将动画脸与来源比较。检查实际交付文件,将其用于项目展示前取得适当批准。
行动入口
把准备好的信息交给 EveryGen AI 的 AI 照片说话
为 EveryGen AI 的 AI 照片说话选择清楚肖像与完成录音,核对当前创建报价,生成说话视觉。听完整结果、检查脸部,再选择最终版本。
创建说话肖像