 EveryGen AI
 · AI 口型同步:匹配短錄音與已有表演
將清楚肖像影片與希望它呈現的錄音配對。EveryGen AI 的 AI 口型同步使用 Sync Lip Sync 2 standard,從兩個檔案生成音訊驅動短結果。仔細準備表演與錄音,再貫穿全片檢查嘴部運動。AI 口型同步從上傳語音開始,不使用輸入對話或聲音生成選單。
影片工作區
上傳一個 MP4/MOV 影片和一個 WAV/M4A 音訊檔案,兩者均須短於 30 秒。點數按音訊時長計算。
Pair the portrait with recorded male speech
14/18查看提示詞
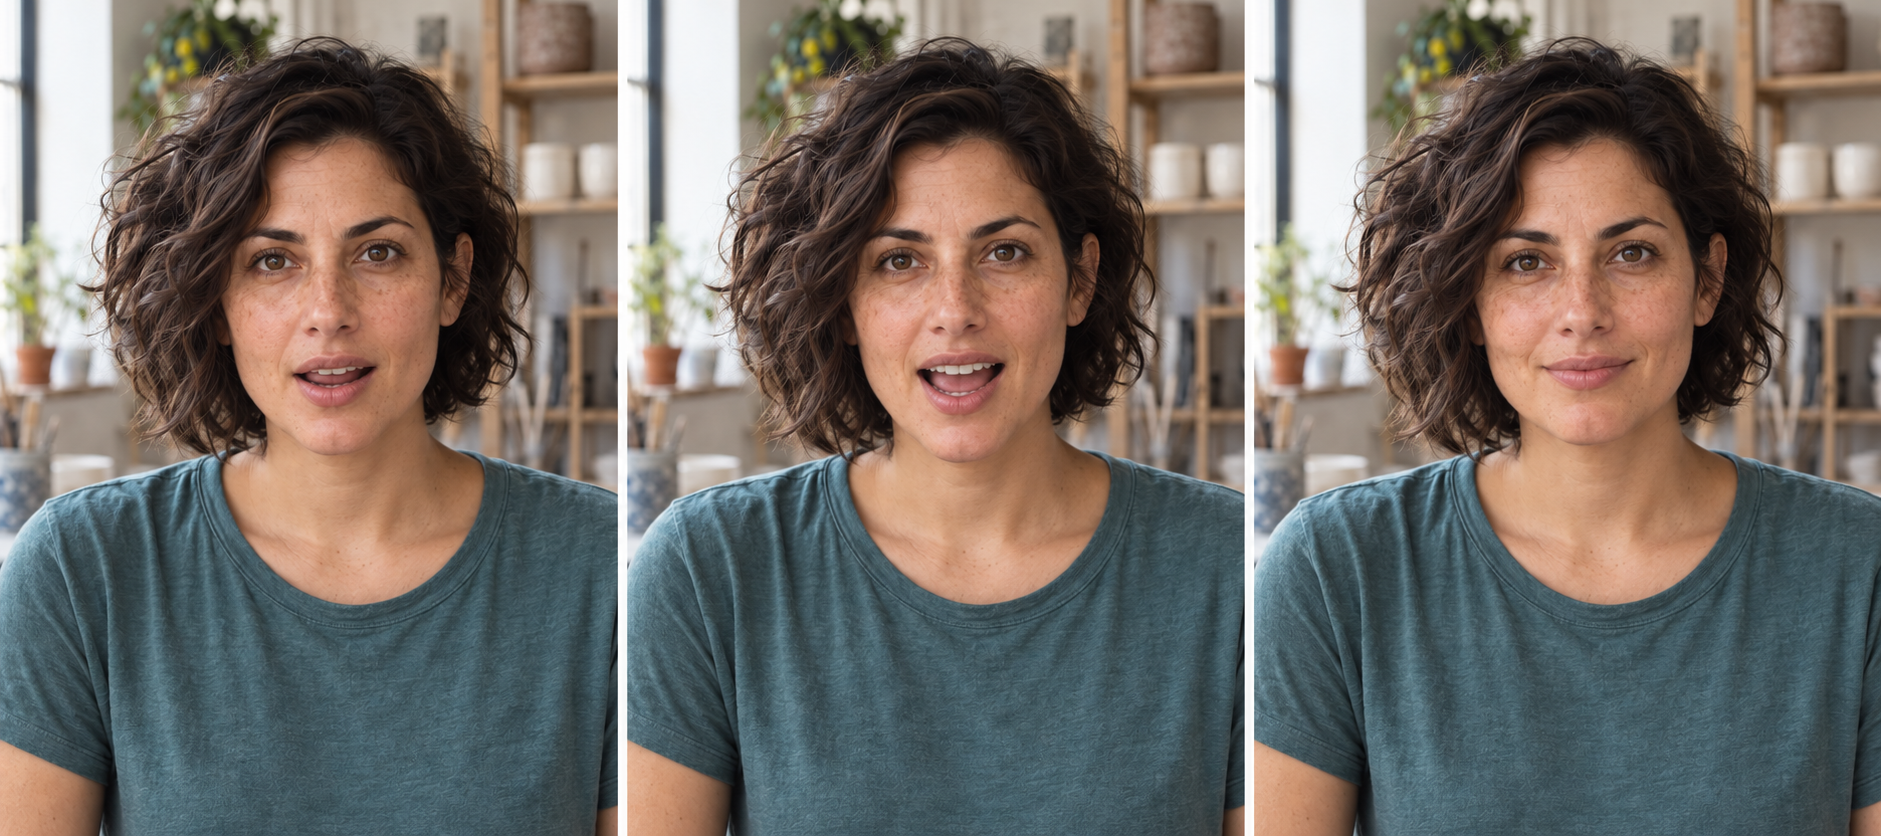
Prepare the authorized adult woman’s portrait video in MP4 or MOV and the provided male speech recording in WAV or M4A, each shorter than thirty seconds. Keep the face and mouth clearly visible. Load Video Input and Audio Reference, then review the audio-length output for mouth timing, natural facial detail, and any repeated movement from loop mode.
簡介
在 EveryGen AI 中給 AI 口型同步清楚聲畫組合
已有視覺表演需要跟隨準備好的錄音時,使用 EveryGen AI 的 AI 口型同步。來源影片與音訊各有不同作用。
處理前選擇訊息
使用 EveryGen AI 的 AI 口型同步前,準備一段介紹、修改後說明或獲准替代錄音。流程使用錄製完成的音訊,不將書面口述稿轉為語音。選擇有完整結尾的訊息。
理解兩項必需檔案
EveryGen AI 的 AI 口型同步要求一個 MP4 或 MOV 影片,以及一個 WAV 或 M4A 音訊,分別短於三十秒。選擇一段清楚錄音和合適肖像表演。頁面不要求逐字稿、語言選擇或文字提示詞。
讓參與者明白用途
使用獲准影片與音訊,可見人物與聲音不同時也一樣。EveryGen AI 的 AI 口型同步建立改動後的表演,不是原始發言證據。讓參與者清楚預期展示方式。
使用方法
如何在 EveryGen AI 中使用 AI 口型同步
- 輸入參考影片 1步驟 1
準備來源組合
給 EveryGen AI 的 AI 口型同步上傳一個 MP4 或 MOV 影片,以及一個 WAV 或 M4A 錄音,每個短於三十秒。
- 範例設定Sync Lip Sync 2source5s
 輸出步驟 2
檢查表演
預覽 EveryGen AI 的 AI 口型同步輸入,確認嘴部可見、語音清楚,肢體運動適合整個錄音時長。
- 示意預覽
The recording guides mouth movement in an existing video. Listen to the input, then inspect the mouth positions.
步驟 3檢查並同步
選擇 Sync Lip Sync 2 standard,核對 EveryGen AI 的 AI 口型同步建立報價,不輸入文字指令即可處理。
- 步驟 4
檢查講話結果
檢查 EveryGen AI 的 AI 口型同步時序、面部細節與迴圈過渡,確認與音訊等長的結果呈現完整訊息,再下載。
功能
選擇嘴部可讀的 AI 口型同步片段
錄音播放時臉部需要始終易懂。給 EveryGen AI 的 AI 口型同步適合可見講話的來源,避免反覆遮擋或突然切換鏡頭。
選擇穩定面部視角
選擇大致正面或稍傾斜、嘴部可讀的臉。EveryGen AI 的 AI 口型同步來源若以快速轉頭或極端側臉為主,會更難檢查。優先嘴唇與下頜可見的穩定表演。
- 使用 EveryGen AI 時,讓嘴部在預期觀看尺寸足夠大,便於判斷。
- 在 EveryGen AI 中預覽 AI 口型同步來源的每次頭部運動。
避免可避免的遮擋
手、麥克風、圍巾或穿過嘴部的物體,會遮住需要檢查的區域。在 EveryGen AI 的 AI 口型同步中選擇相關特徵始終可見的片段。有多個來源時,優先少中斷版本,而非最複雜運鏡。
畫面中保持一個明確講述者
頁面沒有臉部區域選擇控制項。為 EveryGen AI 的 AI 口型同步準備聚焦目標成年講述者的片段,不依賴不存在的選擇工具。檢查全片,避免重要錄音剛開始時主體消失。
給 AI 口型同步錄製完成的錄音
上傳音訊建立講話內容與節奏。生成前為 EveryGen AI 的 AI 口型同步準備好錄音,不期待頁面改寫或演繹它。
錄製簡潔完整訊息
選擇能在支援時長內自然結束的一句或短段。使用 EveryGen AI 的 AI 口型同步前聆聽,確認開頭與最後文字完整。完整表演比突然中斷錄音更容易判斷。
- 使用 EveryGen AI 時,提供一個語音清楚可聽的 WAV 或 M4A。
- 讓 EveryGen AI 的 AI 口型同步來源音訊短於三十秒。
減少來源干擾
選擇講話不被音樂、另一人或室內雜訊淹沒的錄音。EveryGen AI 的 AI 口型同步在此並非音訊清理流程。更清楚錄音,讓可見口部動作與聽眾實際聽到的內容有更好比較基礎。
上傳前完成停頓安排
過長開頭靜音或不必要尾音會改變結果需要的畫面時間。使用 EveryGen AI 的 AI 口型同步前,在自己的音訊流程修剪這些部分,同時保留自然呼吸與句間停頓。不移除賦予講話含義的節奏。
圍繞音訊時長規劃 AI 口型同步
EveryGen AI 的 AI 口型同步為準備好的錄音使用設定的 loop 模式。圍繞音訊規劃視覺來源,再檢查結果時長與重複動作。
先比較兩個時長
檢查錄音比可見來源表演短還是長。EveryGen AI 的 AI 口型同步需要覆蓋超過一遍來源影片的音訊時,視覺重複可能明顯。選擇適合完整訊息的來源動作。
- 使用 EveryGen AI 時,預覽所選視覺來源並聽完整錄音。
- 檢查 EveryGen AI 的 AI 口型同步中手勢回到起點的迴圈過渡。
優先可重複肢體語言
平靜姿勢比戲劇性手勢後離開畫面更易重複使用。在 EveryGen AI 的 AI 口型同步中選擇肢體語言適合完整錄音的片段,再檢查重複運動是否分散對後續文字的注意。
讓錄音定義結尾
EveryGen AI 的 AI 口型同步傳送來源影片與上傳錄音,並選擇 loop 模式。按音訊時長規劃訊息,再核對實際返回時長,不假定原影片長度不變。保持最終句完整,檢查結束有無突然切斷或干擾重複。
按實際檔案控制項使用 AI 口型同步
將準備與處理分開。EveryGen AI 的 AI 口型同步使用來源影片和音訊參考輸入,不需要一段場景指令。
選擇已核對流程
選擇 Sync Lip Sync 2 standard,把準備好的檔案放進對應輸入。EveryGen AI 的 AI 口型同步在此不提供文字轉語音欄位或語言選單。上傳錄音提供待處理講話表演,而非輸入的語言選項。
把範例當作素材準備說明
範例卡描述待準備或載入素材,不是 EveryGen AI 的 AI 口型同步文字命令。選擇清楚臉部與合適錄音,再預覽實際檔案。合適範例描述不能彌補上傳錯版本。一至四個輸出是獨立處理候選,不是自動機位或完成序列。沒有獨立比例或原生音訊開關。
核對目前建立報價
實際媒體時長影響處理報價。載入目標 EveryGen AI 的 AI 口型同步檔案後檢查建立報價,不依賴固定點數數字。更換錄音後,再次提交前重查時長與報價。
按正常播放速度評價 AI 口型同步
不只看一個可信嘴形。EveryGen AI 的 AI 口型同步檢查應覆蓋整句時序、面部外觀、重複運動與最終停頓。
看講話起止
按正常速度播放結果,留意嘴部活動是否隨錄音開始和停穩。先看整體,再在可疑時刻暫停。EveryGen AI 的 AI 口型同步可能靜態影格合理,連續口部動作卻顯得早、晚或過於繁忙。
檢查牙齒與面部邊界
講話時檢視嘴唇、牙齒、下頜和臉頰周圍。EveryGen AI 的 AI 口型同步即使時序可接受,也可能引入重要視覺變化。將這些特徵與來源比較,檢查臉部在不同聲音中是否仍自然。
按需修改輸入
配對仍分散注意時,選擇更好視覺版本,或在外部調整錄音。EveryGen AI 的 AI 口型同步沒有文字修復控制項。儲存原檔案與核准輸出,方便合作者比較後續版本。提交前登入並確保點數足夠。上傳與結果儲存到帳戶,處理需要網路和雲端服務供應商。按實際檔案核對目前報價。
範例提示詞
Material preparation: portrait video and recorded speech
Prepare an authorized adult portrait video in MP4 or MOV and one clear WAV or M4A speech recording, both shorter than thirty seconds. Keep the mouth visible and choose modest head movement. Load the files into Video Input and Audio Reference, then review timing and any repeated visual movement in the result.
Material preparation: a complete short introduction
Choose a portrait video with a calm, repeatable posture and record one complete short introduction as WAV or M4A. Leave natural sentence pauses while removing unnecessary leading silence in your own audio editor. Keep both files below thirty seconds. Review the final audio-length performance for clear articulation and a natural ending.
工作流程示例
規劃、生成和檢查作品的示例情境。
EveryGen AI 工作流程範例
從產品照片和明確的圖片編輯需求開始。將初稿與原圖比較,核對外形、標籤和比例,再放入商品頁面。在設計應用程式中補上已確認的標誌和準確文案。
選擇影片模型,描述一個小動作,例如物體緩緩轉動。核對可用時長、解析度和點數。將鏡頭用於後續剪輯前,檢查物體連續性和聲音。
向圖片工作區說明主體、視角和呼應文章主題的視覺隱喻。在目標版面中預覽結果。若圖片搶走標題的注意力或遮擋重要細節,請調整裁切或構圖。
圖片尺寸合適但檔案偏大時,登入後使用圖片壓縮工具。壓縮在瀏覽器中完成,輸入與結果會儲存到你的帳戶。下載單張圖片或 ZIP 前,請先比較結果。
將草稿貼到 Humanize AI,選擇自然、親切或專業語氣。核對改寫後的意思、名稱、數字和技術術語,再複製或下載已檢查的版本;偵測分數和發表結果不受保證。
將配色、視角、光線和主體尺度記錄在可重複使用的創作說明中。所選圖片模型支援參考圖時,請提供相關素材。將圖片放在一起比較,針對差異修改,勿假設整個系列會自動保持一致。
EveryGen AI · MiniMax H3 Max 價格與點數套餐
隨時取消
Lite
50%折扣0.025/點數
每年計費$179· 節省$179.8
影片模型


圖像模型


- 包含 MiniMax H3 及所有高階模型
- 最多 1 個批次生成任務
- 標準生成速度
- 標準生成成功率
- 標準客戶支援
- 商業使用許可
Standard
50%折扣0.017/點數
每年計費$299· 節省$299.8
影片模型
圖像模型
- 包含 MiniMax H3 及所有高階模型
- 最多 4 個批次生成任務
- 優先處理速度
- 高生成成功率
- 優先客戶支援
- 商業使用許可
Pro
50%折扣0.014/點數
每年計費$599· 節省$599.8
影片模型
圖像模型
- 包含 MiniMax H3 及所有高階模型
- 最多 10 個批次生成任務
- 最快生成速度
- 高生成成功率
- 專屬客戶經理
- 商業使用許可
Max
50%折扣0.012/點數
每年計費$1,199· 節省$1,199.8
影片模型
圖像模型
- 包含 MiniMax H3 及所有高階模型
- 最多 10 個批次生成任務
- 最快生成速度
- 高生成成功率
- 專屬客戶經理
- 商業使用許可
透過以下方式安全支付





常見問題
常見問題
AI 口型同步會把書面口述稿變成講話嗎?
EveryGen AI 的 AI 口型同步不會。請準備並上傳 WAV 或 M4A 錄音。本頁沒有文字轉語音、輸入提示詞或語言選擇控制項。來源音訊提供訊息和節奏。
AI 口型同步接受哪些檔案?
EveryGen AI 的 AI 口型同步使用一個 MP4 或 MOV 影片,以及一個 WAV 或 M4A 音訊,每個都必須短於三十秒。選擇清楚可見講述者與錄製完成的錄音,不用很長無關片段序列。
什麼決定 AI 口型同步輸出時長?
此 loop 設定中,上傳音訊決定 EveryGen AI 的 AI 口型同步輸出時長。錄音超過一遍來源表演時,檢查視覺重複。不假定原影片長度就是最終時長。
AI 口型同步能在合照影片中選擇臉部嗎?
EveryGen AI 的 AI 口型同步介面沒有臉部區域選擇控制項。選擇聚焦目標成年講述者的來源片段。讓嘴部貫穿表演可見,不依賴頁面不接受的指令。
AI 口型同步保證精確嘴部時序嗎?
EveryGen AI 的 AI 口型同步不保證精確對齊或面部外觀不變。帶聲音觀看完整結果,檢查句子開頭、停頓和嘴部區域。遮擋或不合適手勢妨礙表演時,選擇更好的來源組合。
開始創作
用 EveryGen AI 的 AI 口型同步匹配準備好的錄音
為 EveryGen AI 的 AI 口型同步選擇清楚肖像表演與錄製完成的錄音,核對建立報價,再處理組合。帶聲音看完整訊息,選擇要分享的版本。
同步錄好的語音