 EveryGen AI
 Opus 5.5 指南:最佳影片時間線
透過 EveryGen AI 研究插畫最佳影片時間線。檢查參考來源、時長、字幕與歷史,再規劃動效專案。
從這裡開始:開啟 EveryGen AI Opus 電影史時間線。
觀看 OPUSCAR 98 已發布插畫回顧。提供的網頁 MP4 測得 391.424 秒,即 6:31.424;作者作品介紹現已給出一致的約略長度。下方完整提示詞保留的 6:25 描述已過時:用創作需求時按目前來源更新該參考,保留實際容器時長,不重新定時檔案。LemoLab 將程式碼製作影片歸於 Claude Opus 5.5;這裡未獨立核實那些模型工作階段或 EveryGen AI 重現。
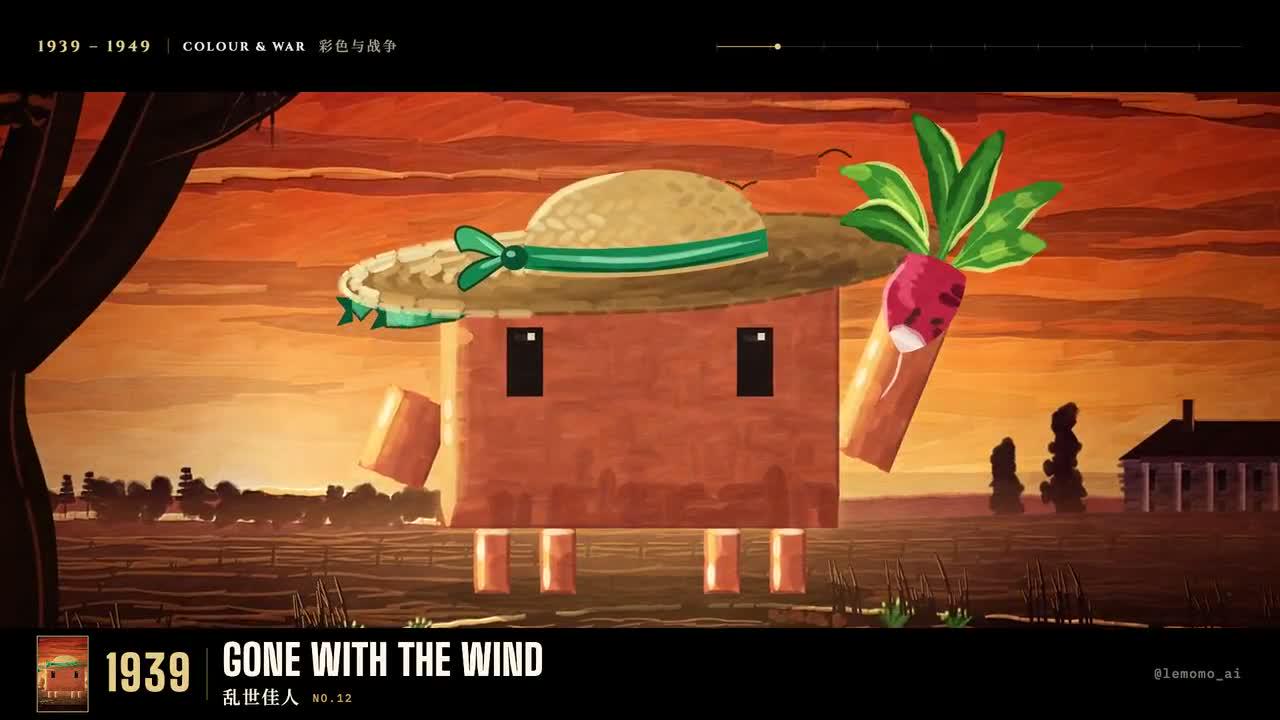
OPUSCAR 98 原片畫面。來源:LemoLab。
1. 找實際專案,不虛構風格資料夾
用參考規劃 EveryGen AI 電影史研究,或開展獨立本地重建。明確選擇交付物。EveryGen AI 概念可探索字幕、插畫與運動關係;重現完整歷史順序,需要證據和外部工作,短提示詞無法替代。
EveryGen AI 創作需求應區分歷史時間線與電影啟發蒙太奇。時間線用順序和標籤作事實陳述,情緒序列則可只探索視覺處理。寫 EveryGen AI 提示詞前決定目標,不讓觀眾從裝飾畫面猜歷史。
把原專案缺失當作證據邊界。不把 EveryGen AI 版本稱為恢復原始碼,不從相鄰範例推斷缺少的建置檔案。將 EveryGen AI 指令、新寫重建程式碼與來源審查筆記,同創作者實際提供檔案分開。
有用 EveryGen AI 適配可聚焦選定歷史片段,不把完整發布壓縮到無法閱讀。記錄省略內容與原因。EveryGen AI 研究應說明範圍,不暗示參考的每個獲獎片、章節與節奏點都存在。
畫廊建立器的作品來源說明明確將影片放在倉庫未包含的 promo/。沒有 styles/opuscar98/STYLE.md,也沒有已核實的公開一鍵重建命令。
準確原始碼重建需要原專案。下方流程改用公開 Lemo 工具重建已發布影片順序,並明確標為重建。新檔案絕不能當作恢復的作者程式碼。
2. 記錄實際影片,核對獲獎作品
生成 EveryGen AI 時間線前,建立純文字證據記錄。每個目標條目保留可見標題、擬用標籤、核實來源與衝突。EveryGen AI 可幫助視覺安排,事實核實仍為獨立任務,不是設計隱含屬性。
規劃 EveryGen AI 序列時,分開記錄發行年與頒獎年。決定卡片顯示哪種,始終說明同一規則。EveryGen AI 動畫可能看起來按時間,混合日期規則卻悄悄錯放條目;漂亮過渡不解決差異。
參考標題卡不可讀時,先記錄不確定性,再寫 EveryGen AI 創作需求。查詢有記錄的獎項資料,比較周圍序列,不虛構缺失標題。不為讓 EveryGen AI 版面配置平衡而補空缺。
EveryGen AI 計畫中,將歷史資料與插畫筆記分開。新繪場景可暗示年代或故事,不應代表檔案劇照。EveryGen AI 審查時,檢查配文是否說明插畫作用,不暗示它證明歷史事件或影片細節。
請求 EveryGen AI 動效前,給可讀標題分配空間。長名可能比短名需要不同換行,日期仍應關聯正確條目。按目標展示尺寸審查 EveryGen AI 設計;只在放大截圖才能辨認的文字,需要新版面配置。
外部重建素材與 EveryGen AI 概念分開準備。提供的準備命令建立工作區,不建立缺失作品原始碼。下載發布保持不變;本地重建稱為完成前,明確清點現有、缺失與新寫內容。
參考 MP4 保持不變。在 timeline.csv 記錄每個可見標題、顯示年、章節、插畫說明及開始結束時間。對照Academy 獎項記錄。分開發行年與頒獎年,不為達到 98 而補不可讀卡或重複標題。
保留從早期到當代電影的進展,可用不同視覺處理。插畫稱為解釋,不稱檔案劇照。重複使用前記錄圖稿、角色、字型與聲音來源。
使用獨立終端,準備 Git、Node 20+、FFmpeg/ffprobe,以及 Python 3.11–3.13 或 uv:
git clone https://github.com/lemomo-ai/lemo-opuscar.git cinema-study
cd cinema-study
export LEMO_OPUSCAR_HOME="$PWD"
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps voice
D=study/opuscar98
mkdir -p "$D/reference" "$D/evidence" "$D/out"
git rev-parse HEAD > "$D/evidence/commit.txt"
將下載影片複製到該目錄的 reference/opuscar98.mp4。保留鎖定檔案與已解析的依賴版本。準備命令不會恢復未發布 promo/ 專案。
3. 給 Opus 完整重建創作需求
下方程式設計提示詞為新寫。EveryGen AI 專案應按本站動效控制項適配選定視覺片段,不把外部建置指令提交得彷彿 EveryGen AI 是終端。在自己的創作需求定義開場、資訊順序、過渡與最終閱讀停留。
分配詳細節奏前,選擇 EveryGen AI 時長和寬高比。短專案可能需減少條目,而非加快標籤。參考片長不會成為 EveryGen AI 可用時長;濃縮片段不證明完整回顧已重現。
首先關心構圖、字幕位置與層級時,用 EveryGen AI Sketch;準備檢查節奏時,用 Motion。下一草稿前保留接受的 EveryGen AI 專案版本,讓後續變化可對照已知安排,而非預覽記憶。
EveryGen AI 時間線應指定已核實字幕順序與插畫作用。避免模糊要求電影史而讓模型虛構事實。生成後,將 EveryGen AI 文字與核准記錄比較,包括拼寫、年份關聯、卡片是否意外重複或消失。
在 EveryGen AI 研究中,將音訊視為獨立製作決定。目前動效流程建立無聲視覺專案。外部加聲音時,與接受畫面剪輯核對並記錄來源;不描述 EveryGen AI 匯出自動重現參考配樂。
有幫助 EveryGen AI 創作需求包含修訂中應穩定內容:歷史順序、核實標籤、選定視覺處理與閱讀空間,同時點明請求變化。指令幫助檢查,卻不能替代檢查 EveryGen AI 專案全部卡片和過渡。
新提示詞,不是作者原始對話:
Reconstruct the published OPUSCAR 98 case from the supplied MP4 and checked
timeline.csv. Inspect the repository commit, locks, DIRECTOR.md, TECHNIQUE.md,
core/README.md, and gallery feature-source note. The original promo/ project
is absent: do not invent its files, build commands, prompts, or model logs.
Preserve the observed chronological structure, verified years/titles, chapter
changes, and readable illustrations. Compare entries with Academy records;
flag conflicts rather than fabricating history. Keep author attribution.
Implement new source in study/opuscar98: index.html, timeline.js, chapter
modules, credits, and mix.py. Label this an independent reconstruction.
Use the installed READY/render(t)/DUR interface, absolute time, fixed seeds,
and reproducible forward/reverse seeks. Choose 24 fps for this reconstruction,
quantize cues to integer frames, and record duration separately from the
391.424-second reference container and README's 6:25 description.
Build the audio master from cleared supplied material and reviewed timings;
do not invent narration or silently substitute an uncleared soundtrack.
Keep every title, caption, image and cue linked to its evidence. Implement
mix.py to write out/mix.wav. Missing evidence/assets must be identified,
not masked. Otherwise proceed using documented core commands. Save prompts,
actual model/provider/effort/session details, changes and checks. Do not publish.
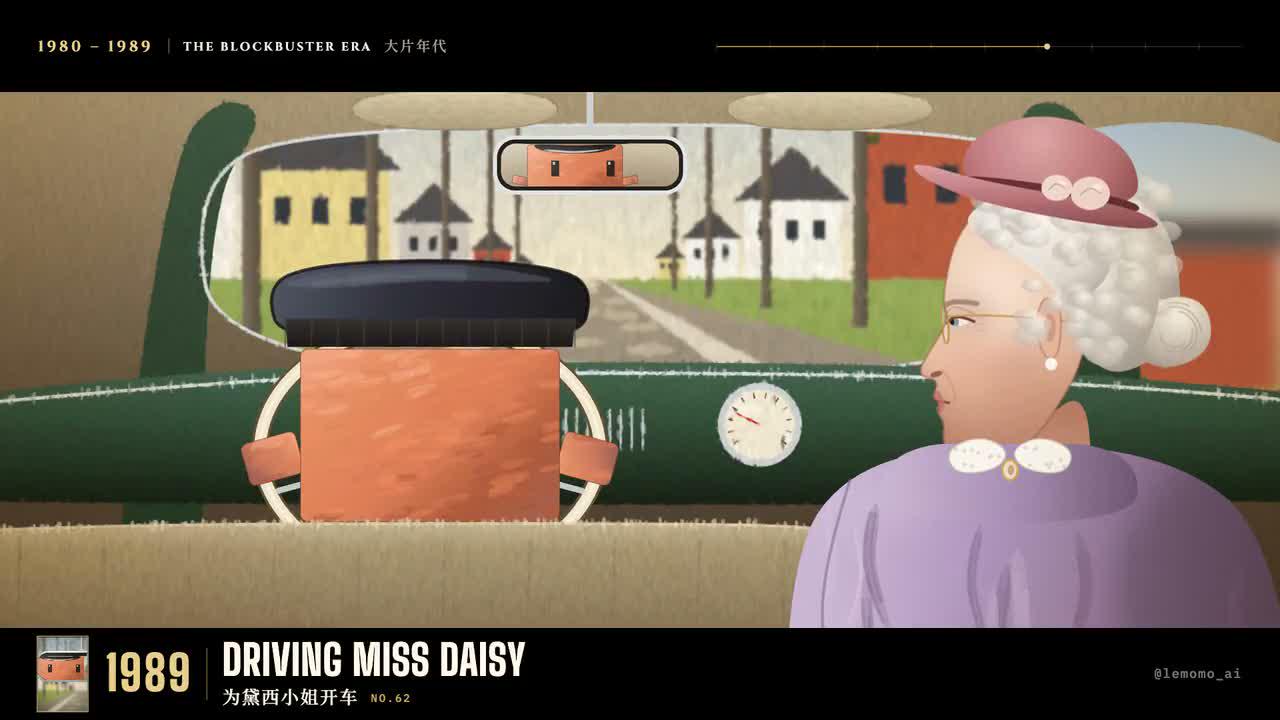
另一幀作者影片畫面;保留年份與標題前後脈絡。
4. 只渲染已實現的重建
EveryGen AI 預覽與外部渲染回答不同製作問題。前者展示請求概念,後者用依賴與素材處理新實現原始碼。準確標註兩種結果,不把 EveryGen AI 草稿當作獨立重建命令成功執行的證據。
在停留與過渡期間審查 EveryGen AI 卡。字幕靜態影格可能正確,卻沒足夠閱讀時間或與下一條重疊。先不暫停觀看 EveryGen AI 序列,再檢查困惑過渡,區分節奏、版面配置或事實問題。
把章節變化與接受的 EveryGen AI 大綱比較。過渡應幫助觀眾定位,不悄然跳內容,或把標題關聯前幅插畫。用書面計畫定位目標邊界,同時要求 EveryGen AI 播放本身無需持續解釋也能傳達順序。
本地重建儲存抽樣影格與實際渲染中繼資料作證。EveryGen AI 則保留接受專案版本、檢查匯出影片。完成訊息或單張漂亮影格,都不能確定全部字幕、插畫與過渡在完整序列中一致。
外部音訊改變長度時,交接前協調聲畫。原參考保持獨立。EveryGen AI 無聲專案匯出應可區別後期編輯版本,包括別處完成的字幕、音樂或旁白。
新頁面與混音器存在後,用 Lemo 共享渲染介面,不用不存在的作品建置腳本:
.venv/bin/python "$D/mix.py"
node core/render/still.mjs "$D" 0 --out "$D/evidence/stills"
node core/render/video.mjs "$D" --fps 24 --workers 2 --out "$D/out/picture.mp4"
sh core/render/mux.sh "$D/out/picture.mp4" "$D/out/mix.wav" "$D/out/study.mp4" 24 0
ffprobe -v error -count_frames -show_streams -show_format -of json "$D/out/study.mp4"
ffmpeg -v error -i "$D/out/study.mp4" -f null -
在記錄章節邊界擷取更多影格。封裝前檢查完整聲音尾部:共享 mux 可能按畫面長度裁音訊。
5. 修正歷史順序,驗收完整剪輯
每個 EveryGen AI 修正圍繞觀察問題:標題拼錯、日期關聯錯誤、卡片重複或停留太急。明確接受順序,修訂後檢查相鄰卡。EveryGen AI 請求修字幕,不保證其他插畫或過渡不變。
EveryGen AI 輸出事實出錯時,改詞前回到核實記錄。合理替換不足夠。必需字幕無法可靠渲染時,簡化版面配置或在外部完成準確文字,同時保留選定 EveryGen AI 視覺研究為獨立源版本。
重新開啟最終匯出,與接受時間線比較。檢查開頭、章節順序、每個可見標題與結尾停留。根據實際完成工作描述結果:短視覺研究或獨立重建。保留未解決歷史問題,不轉成自信字幕。
一起交接證據記錄、接受專案、所用素材、修訂筆記與最終輸出。接收者應能追溯每個事實標籤的支援記錄,區別原片與你的新作,讓後續可修正,不必從成片猜全部理由。
Correct only the observed year/title, illustration, or timing mismatch.
Update linked captions and audio together. Preserve chronology and reading
holds; show the evidence, source diff, and fresh boundary frames.
原發布畫面,不是新完成重建的證據。
將解碼影格數與重建實際影格計畫比較,再全程觀看、聆聽。歸檔證據、原始碼、提示詞、版本、編輯與 MP4。倉庫許可以 MIT 覆蓋軟體,不自動取得影片畫面、角色、音樂或其他第三方素材權限。