 EveryGen AI
のOpus 5.5ガイド:作品賞のタイムライン
EveryGen AIで、図版を使った作品賞のタイムラインを検討。映像プロジェクトを計画する前に、参考元、タイミング、字幕、歴史情報の確認を行いましょう。
まず、映画史のタイムラインを検討するEveryGen AI Opusを開きます。
公開されている図版付きの回顧映像OPUSCAR 98を視聴してください。提供されたウェブ用MP4の長さは391.424秒、つまり6:31.424です。作者の作品紹介も、現在はそれに合う丸めた長さを示しています。下の完全なプロンプトに残る6:25という説明は古いものです。制作指示を使う際は、その参照を現在の情報へ更新し、ファイルの速度や長さを変更せず、実際のコンテナの長さを保ってください。LemoLabは、コードで制作した映像にClaude Opus 5.5を使用したとしています。そのモデルのセッションも、EveryGen AIでの再現も、ここでは独立して検証していません。
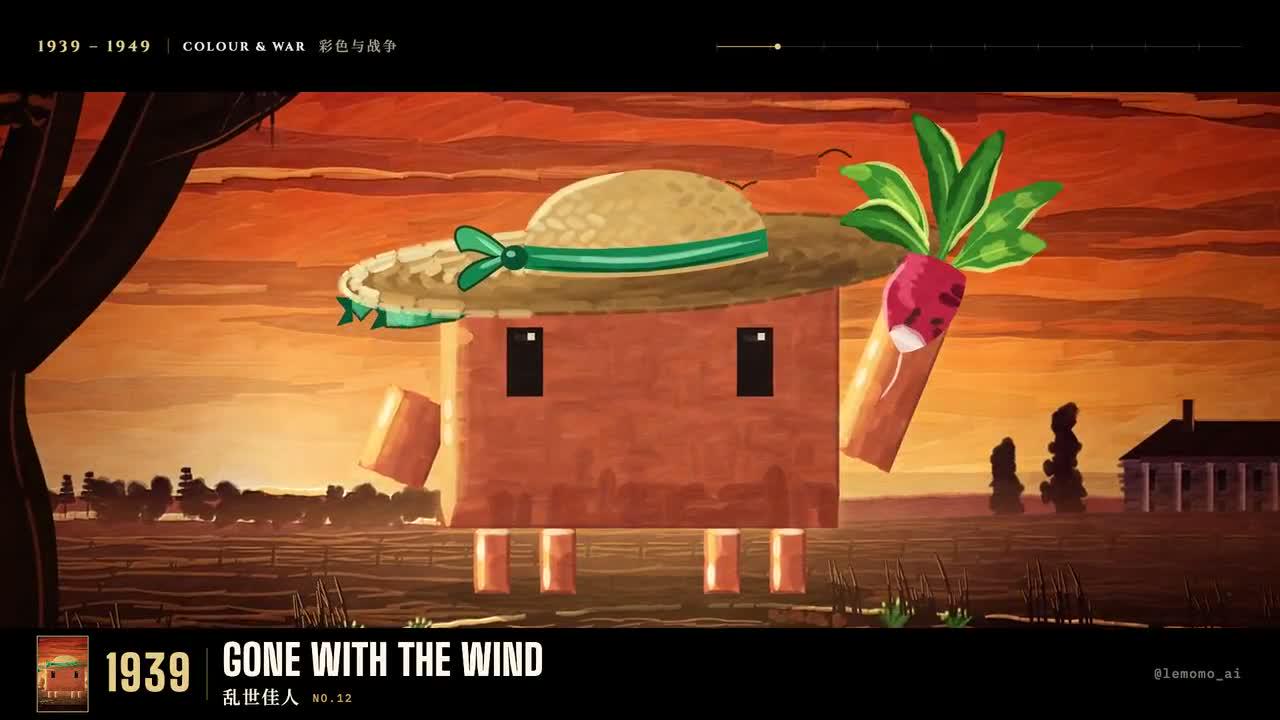
元のOPUSCAR 98のフレーム。クレジット:LemoLab。
1. 架空のスタイルフォルダーではなく、プロジェクトを探す
この参考を使い、EveryGen AIで映画史の検討を計画するか、独立したローカルでの再構成を行います。成果物を明確に選んでください。EveryGen AIのコンセプトでは、字幕、図版、動きの関係を探れます。作品全体の時系列を再現するには、短いプロンプトで置き換えられない根拠と外部作業が必要です。
EveryGen AIの制作指示では、歴史的なタイムラインと、映画から着想したモンタージュを区別します。タイムラインは、順序とラベルを通して事実を主張します。一方、雰囲気を中心とする映像は、見た目の表現を探るだけの場合があります。EveryGen AIのプロンプトを書く前に、どちらを意図するか決め、装飾的な画像から歴史を推測させないようにしてください。
元プロジェクトがないことを、根拠の限界として扱います。EveryGen AI版を取り戻したソースと説明せず、隣の作例から欠けたビルドファイルを推定しないでください。EveryGen AIへの指示、新たに書いた再構成コード、元資料の確認メモを、制作者が実際に提供したファイルと分けて保管します。
EveryGen AIで役立つ応用を作るには、完全な公開映像を読めないほど圧縮せず、選んだ時系列の一部分に絞る方法もあります。省いた内容と理由を記録してください。出来上がったEveryGen AIの検討映像は、参考の受賞作、章、タイミングの手がかりをすべて含むように見せず、対象範囲を明示します。
ギャラリービルダーの作品ソースに関する注記は、この映像を、リポジトリに含まれないpromo/に明示的に位置付けています。この作品のstyles/opuscar98/STYLE.mdや、公開され検証された一コマンドの再ビルド手順はありません。
正確なソースからの再ビルドには、その元プロジェクトが必要です。以下の方法では、代わりに公開のLemoツールを使って公開映像の時系列を再構成し、再構成であることを明示します。新しく書いたファイルを、取り戻した作者のコードとして扱ってはいけません。
2. 実際の映像を整理し、受賞作を確認する
EveryGen AIのタイムラインを生成する前に、プレーンテキストで根拠を記録します。含める各項目について、見える作品名、提案するラベル、確認に使った資料、食い違いを残してください。EveryGen AIは視覚的な配置を助けられますが、事実の確認は別作業であり、デザインから推定できる性質ではありません。
EveryGen AIの流れを計画する際は、映画の公開年と授賞式の年を別の項目に保ちます。カードにどちらを表示するか決め、その規則を一貫して明示してください。EveryGen AIのアニメーションが時系列に見えても、年の規則を混ぜると、項目を誤った位置へ移してしまうことがあります。魅力的な切り替えでは、その食い違いは解消しません。
参考のタイトルカードが読めない場合は、EveryGen AIの制作指示を作る前に、不確かさを記録します。記録された受賞資料を参照し、欠けた作品名を作り出さず、前後の流れと比較してください。EveryGen AIの配置のバランスがよくなるという理由だけで、空白を別の項目で埋めないようにします。
EveryGen AIの計画では、歴史データと図版のメモを分けます。新たに描いた場面は、時代や物語を示唆できますが、記録映像の静止画として扱うべきではありません。EveryGen AIの確認では、添えた文章が、歴史的な出来事や映画の細部の証拠だと暗示せず、図版の役割を明確にしているか点検します。
EveryGen AIで動きを依頼する前に、読める作品名のための空間を確保します。長い名前には短い名前と異なる改行が必要な場合があり、年は正しい項目と結び付けておきます。EveryGen AIのデザインを予定する表示サイズで確認してください。拡大したスクリーンショットでしか読めない文字には、新たな配置が必要です。
外部の再構成素材は、EveryGen AIのコンセプトと別に準備します。提供された準備コマンドは、作業環境を用意するもので、欠けた作品ソースではありません。ダウンロードした公開映像を変更せず、ローカルの再ビルドを完成と呼ぶ前に、利用できるもの、欠けたもの、新たに書いたものの一覧を明示してください。
参考MP4は変更せずに保ちます。見える各作品名、表示年、章、図版の説明、開始と終了時刻をtimeline.csvへ記録してください。Academyの受賞記録と照合します。映画の公開年と授賞式の年を分け、98に達するためだけに、読めないカードを補ったり、作品名を重複させたりしないでください。
表現方法の違いを認めながら、初期の映画から現代の映画への流れを保ちます。図版は記録映像の静止画ではなく、解釈と説明してください。再利用の前に、アート、人物、文字組み、サウンドトラックの来歴を記録します。
Git、Node 20+、FFmpeg/ffprobe、Python 3.11–3.13またはuvを用意した、別のターミナルを使います。
git clone https://github.com/lemomo-ai/lemo-opuscar.git cinema-study
cd cinema-study
export LEMO_OPUSCAR_HOME="$PWD"
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps voice
D=study/opuscar98
mkdir -p "$D/reference" "$D/evidence" "$D/out"
git rev-parse HEAD > "$D/evidence/commit.txt"
そのディレクトリ内のreference/opuscar98.mp4へ、ダウンロードした映像をコピーします。ロックファイルと解決した依存関係を残してください。これらの準備コマンドは、未公開のpromo/プロジェクトを復元しません。
3. 再構成の完全な制作指示をOpusへ渡す
下のコーディング用プロンプトは、新たに書いたものです。EveryGen AIのプロジェクトでは、外部のビルド指示を、EveryGen AIがターミナルであるかのように送らず、選んだ視覚的な抜粋を、サイトで使える動きの操作へ合わせてください。冒頭、情報の順序、切り替え、最後の読ませる静止時間を、自分の制作指示で定めます。
細かな進行速度を割り当てる前に、EveryGen AIの長さと縦横比を選びます。短いプロジェクトでは、ラベルを速く流すより、項目を減らす必要がある場合があります。参考の上映時間が、EveryGen AIで使える長さになるわけではありません。圧縮した抜粋で、回顧映像全体を再現したことにはなりません。
最初の確認事項が構図、字幕の配置、視覚的な優先順位なら、EveryGen AIのSketchを使います。タイミングを確認する準備ができたら、Motionを使ってください。別の案を求める前に、受け入れたEveryGen AIのプロジェクト版を残します。プレビューの曖昧な記憶ではなく、既知の配置と、後の変更を比較できるようにしてください。
EveryGen AIのタイムラインには、確認済み字幕の意図する順序と、図版の役割を指定します。事実の内容を創作に任せる、映画史についての曖昧な依頼は避けてください。生成後は、EveryGen AIの文章を承認記録と比較し、綴り、年との対応、カードの予期しない重複や消失を確認します。
EveryGen AIの検討では、音声を別の制作判断として扱います。現在の動きの手順は、無音の映像プロジェクトを作ります。外部で音を加える場合は、受け入れた映像編集と照合し、出所を記録してください。EveryGen AIの書き出しが、参考のサウンドトラックを自動で再現すると説明しないようにします。
役立つEveryGen AIの制作指示には、時系列、確認済みラベル、選んだ見た目の表現、読む空間など、修正中も安定させるものを含めます。依頼する具体的な変更も示してください。これらは確認を助けますが、結果のEveryGen AIのプロジェクトの全カードと切り替えの点検に代わるものではありません。
新しいプロンプトであり、作者の元の会話ではありません。
Reconstruct the published OPUSCAR 98 case from the supplied MP4 and checked
timeline.csv. Inspect the repository commit, locks, DIRECTOR.md, TECHNIQUE.md,
core/README.md, and gallery feature-source note. The original promo/ project
is absent: do not invent its files, build commands, prompts, or model logs.
Preserve the observed chronological structure, verified years/titles, chapter
changes, and readable illustrations. Compare entries with Academy records;
flag conflicts rather than fabricating history. Keep author attribution.
Implement new source in study/opuscar98: index.html, timeline.js, chapter
modules, credits, and mix.py. Label this an independent reconstruction.
Use the installed READY/render(t)/DUR interface, absolute time, fixed seeds,
and reproducible forward/reverse seeks. Choose 24 fps for this reconstruction,
quantize cues to integer frames, and record duration separately from the
391.424-second reference container and README's 6:25 description.
Build the audio master from cleared supplied material and reviewed timings;
do not invent narration or silently substitute an uncleared soundtrack.
Keep every title, caption, image and cue linked to its evidence. Implement
mix.py to write out/mix.wav. Missing evidence/assets must be identified,
not masked. Otherwise proceed using documented core commands. Save prompts,
actual model/provider/effort/session details, changes and checks. Do not publish.
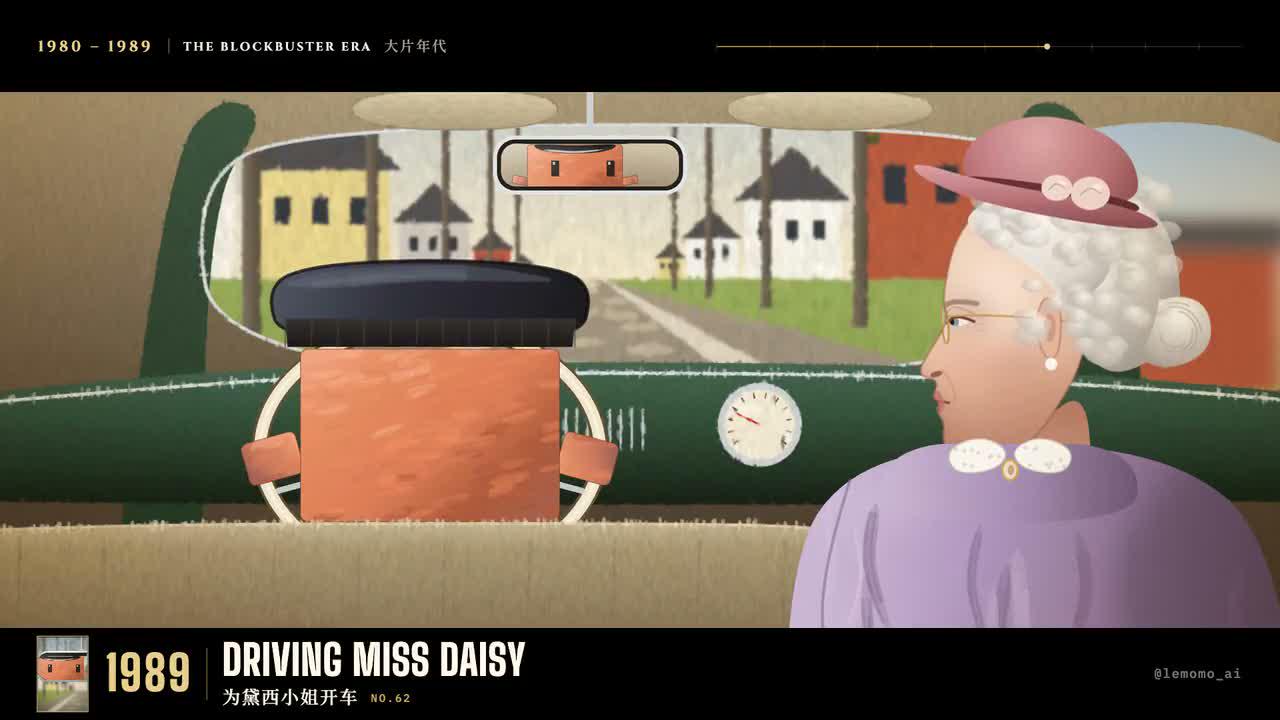
作者の映像の別のフレーム。年と作品名の文脈を保ってください。
4. 実装した再構成だけをレンダリングする
EveryGen AIのプレビューと外部のレンダリングは、異なる制作上の問いに答えます。前者は依頼したコンセプトを示し、後者は、新たに実装したソースを、依存関係や素材とともに処理します。両方の結果を正確に表示し、EveryGen AIの案を、独立した再構成コマンドが正常に実行された証拠と呼ばないでください。
EveryGen AIのカードを、静止中と切り替え時に確認します。字幕が静止画では正しくても、読む時間が足りなかったり、次の項目へ重なったりすることがあります。最初はEveryGen AIの流れを止めずに視聴し、その後で分かりにくい切り替えを調べ、タイミング、配置、事実の内容のどれが問題か特定してください。
章の切り替えを、受け入れたEveryGen AIの概要と比較します。切り替えは、内容を黙って飛ばしたり、作品名を前の図版へ結び付けたりせず、見る人の理解を導くものにしてください。文章の計画で意図した区切りを探しつつ、EveryGen AIの再生そのものが、継続的な説明なしで順序を伝えることを求めます。
ローカルの再構成では、抽出したフレームと実際のレンダリング情報を証拠として保存します。EveryGen AIでは、受け入れたプロジェクト版を保ち、書き出した動画を確認してください。完了メッセージも、魅力的な一フレームも、完成した流れ全体で字幕、図版、切り替えが一貫して残った証明にはなりません。
外部で加えた音声の長さが変わったら、引き渡す前に映像と音を整合させます。その際も、元の参考は別に保管してください。EveryGen AIの無音のプロジェクト書き出しは、後で別のアプリで字幕、音楽、ナレーションを加えた版と区別できる状態にします。
新しいページとミキサーを実装してから、存在しない作品用ビルドスクリプトではなく、Lemoの共通レンダリングインターフェースを使います。
.venv/bin/python "$D/mix.py"
node core/render/still.mjs "$D" 0 --out "$D/evidence/stills"
node core/render/video.mjs "$D" --fps 24 --workers 2 --out "$D/out/picture.mp4"
sh core/render/mux.sh "$D/out/picture.mp4" "$D/out/mix.wav" "$D/out/study.mp4" 24 0
ffprobe -v error -count_frames -show_streams -show_format -of json "$D/out/study.mp4"
ffmpeg -v error -i "$D/out/study.mp4" -f null -
記録した章の区切りで、追加のフレームを抽出します。多重化の前にサウンドトラックの末尾全体を確認してください。共通の多重化処理は、映像の長さに合わせて音声を切る場合があります。
5. 時系列を修正し、編集全体を受け入れる
EveryGen AIの各修正は、作品名の綴り、誤った年との対応、カードの重複、短すぎる静止時間など、観察した問題を中心に書きます。受け入れた時系列を明示し、修正後には前後のカードも確認してください。EveryGen AIへ字幕の修正を求めても、ほかのすべての図版や切り替えが変わらない保証にはなりません。
EveryGen AIの出力に事実の誤りが現れたら、文面を編集する前に、確認済みの記録へ戻ります。もっともらしい代案では不十分です。必要な字幕を安定して描けない場合は、配置を単純にするか、正確な文字を外部で仕上げてください。その際も、選んだEveryGen AIの視覚的な検討版は、別の元の版として残します。
最終書き出しを開き直し、受け入れたタイムラインと比較します。冒頭、章の順序、見えるすべての作品名、最後の静止時間を確認してください。短い視覚的な検討か、独立した再構成か、実際に終えた作業に合わせて結果を説明します。未解決の歴史上の問いは、確信した字幕へ変えず、見える状態にしてください。
根拠の記録、受け入れたプロジェクト、使った素材、修正メモ、最終出力を一緒に渡します。受け取る人が、各事実ラベルを裏付けの記録までたどれ、元の映像と新たな作業を区別できるようにしてください。完成動画だけから判断過程を再構成せずに、後の修正を行えます。
Correct only the observed year/title, illustration, or timing mismatch.
Update linked captions and audio together. Preserve chronology and reading
holds; show the evidence, source diff, and fresh boundary frames.
元の公開映像のフレームであり、新たな再ビルド完了の証拠ではありません。
デコードしたフレーム数を、再構成の実際のフレーム計画と比較し、全体を視聴して音も確認します。根拠、ソース、プロンプト、版、編集、MP4を保存してください。リポジトリのライセンスは、MITでソフトウェアを対象とします。映画の画像、人物、音楽、その他の第三者素材の利用まで、自動で許諾するものではありません。