 EveryGen AI
Guide EveryGen AI Opus 5.5 : chronologie du meilleur film
Étudiez la chronologie illustrée du meilleur film avec EveryGen AI. Examinez source, minutage, légendes et vérifications historiques avant de préparer un projet animé.
Commencez ici : ouvrez EveryGen AI Opus pour les chronologies de l’histoire du cinéma.
Regardez OPUSCAR 98, la rétrospective illustrée publiée. Le MP4 web fourni dure 391.424 secondes, soit 6:31.424 ; la présentation du long format par l’auteur donne désormais une durée arrondie correspondante. La description de 6:25 conservée dans le prompt complet ci-dessous est dépassée : actualisez cette référence selon la source actuelle lorsque vous utilisez le brief, et conservez la durée réelle du conteneur plutôt que de modifier le minutage du fichier. LemoLab attribue ses films créés par code à Claude Opus 5.5 ; ni ces sessions de modèle ni une reproduction EveryGen AI n’ont été vérifiées indépendamment ici.
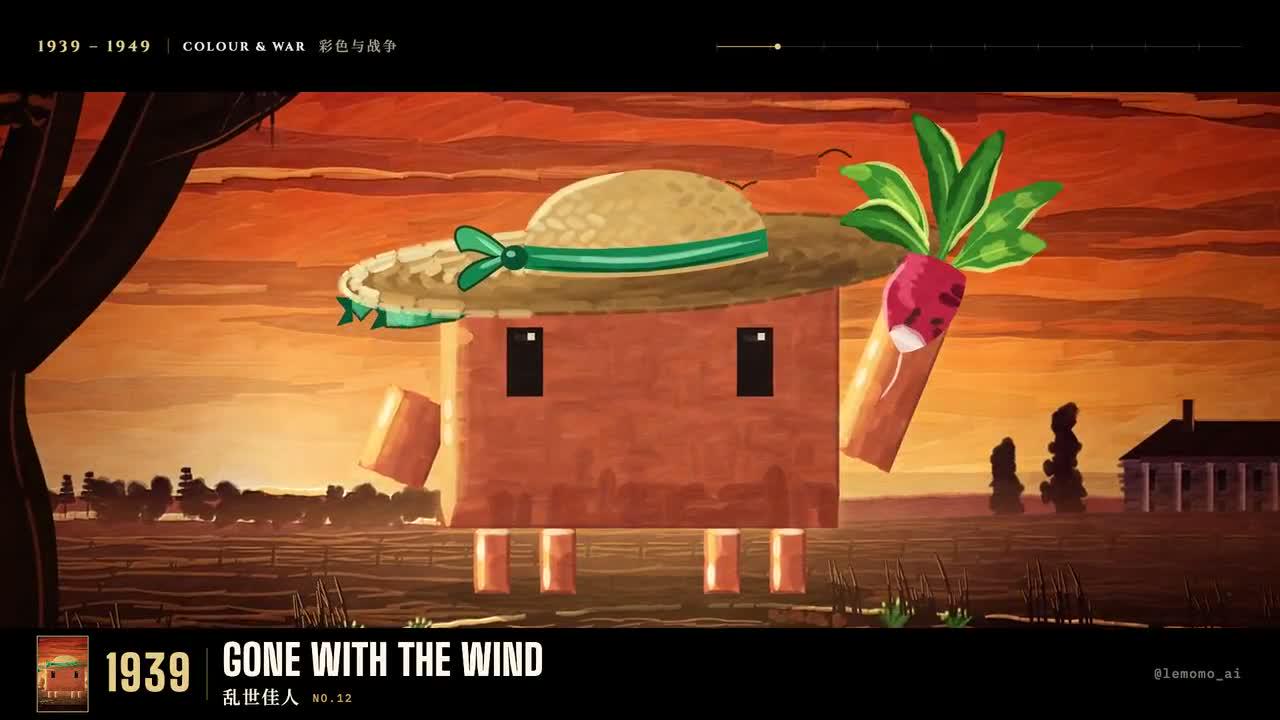
Image originale d’OPUSCAR 98. Crédit : LemoLab.
1. Localisez le projet, pas un dossier de style inventé
Utilisez cette référence pour préparer une étude d’histoire du cinéma EveryGen AI, ou entreprenez une reconstruction locale indépendante. Choisissez explicitement le livrable. Un concept EveryGen AI peut explorer la relation entre légendes, illustrations et mouvement ; reproduire toute la chronologie du long format exige des preuves et un travail externe qu’un court prompt ne remplace pas.
Pour un brief EveryGen AI, distinguez une chronologie historique d’un montage inspiré du cinéma. Une chronologie avance des faits par son ordre et ses libellés, tandis qu’une séquence d’ambiance peut simplement explorer des traitements visuels. Décidez de votre intention avant d’écrire un prompt EveryGen AI pour ne pas demander au public de déduire l’histoire d’images décoratives.
Considérez l’absence du projet original comme une limite des preuves disponibles. Ne décrivez pas une version EveryGen AI comme une source retrouvée et ne déduisez pas les fichiers de construction manquants d’exemples voisins. Gardez vos consignes EveryGen AI, le code de reconstruction nouvellement écrit et les notes d’examen de source séparés des fichiers réellement fournis par le créateur.
Une adaptation EveryGen AI utile peut se concentrer sur un extrait chronologique choisi plutôt que de condenser toute la publication au détriment de la lisibilité. Notez ce que vous avez omis et pourquoi. L’étude EveryGen AI obtenue doit identifier sa portée plutôt que suggérer la présence de chaque gagnant, chapitre et repère temporel de la référence.
La note de source du long format dans le constructeur de galerie place explicitement ce film dans promo/, absent du dépôt. Il n’existe ni styles/opuscar98/STYLE.md ni reconstruction publique vérifiée en une seule commande pour ce long format.
Une reconstruction exacte depuis la source exige ce projet original. Le parcours ci-dessous reconstruit plutôt la chronologie du film publié à l’aide des outils publics Lemo, en étant clairement présenté comme une reconstruction. Ses nouveaux fichiers ne doivent jamais être présentés comme du code d’auteur retrouvé.
2. Cartographiez le film réel et vérifiez les lauréats
Créez un relevé de preuves en texte brut avant de générer une chronologie EveryGen AI. Pour chaque entrée prévue, conservez le titre visible, le libellé proposé, la source de vérification et tout conflit. EveryGen AI peut aider à organiser visuellement les éléments, mais la vérification factuelle reste une tâche séparée, pas une propriété déduite du design.
Gardez l’année de sortie et l’année de cérémonie dans des champs distincts lorsque vous préparez la séquence EveryGen AI. Décidez de celle qui apparaît sur la carte et appliquez cette convention de façon cohérente. Une animation EveryGen AI peut sembler chronologique alors que des conventions mélangées déplacent discrètement une entrée ; de belles transitions ne résolvent pas cet écart.
Si une carte de titre est illisible dans la référence, notez cette incertitude avant de construire le brief EveryGen AI. Consultez le registre documenté des récompenses et comparez la séquence voisine sans inventer le titre manquant. Ne comblez pas une lacune uniquement parce que la disposition EveryGen AI semblerait plus équilibrée avec une autre entrée.
Séparez les données historiques des notes d’illustration dans le plan EveryGen AI. Une scène nouvellement dessinée peut évoquer une époque ou un récit, mais ne doit pas être présentée comme une image d’archive. Pendant l’examen EveryGen AI, vérifiez que le texte d’accompagnement clarifie le rôle de l’illustration au lieu de suggérer qu’elle prouve un événement historique ou un détail de film.
Réservez de l’espace aux titres lisibles avant de demander un mouvement EveryGen AI. Les noms longs peuvent exiger d’autres retours à la ligne que les noms courts, tandis que la date doit rester liée à la bonne entrée. Examinez le design EveryGen AI à la taille d’affichage prévue ; un texte déchiffrable uniquement dans une capture agrandie nécessite une nouvelle disposition.
Préparez les éléments de reconstruction externes séparément du concept EveryGen AI. Les commandes de préparation fournies établissent un espace de travail, pas la source absente du long format. Gardez la publication téléchargée inchangée et dressez un inventaire explicite des éléments disponibles, manquants ou nouvellement écrits avant de déclarer une reconstruction locale terminée.
Gardez le MP4 de référence inchangé. Notez chaque titre visible, année affichée, chapitre, description d’illustration et temps de début/fin dans timeline.csv. Recoupez les entrées avec les registres de récompenses de l’Academy. Distinguez les années de sortie des films des années de cérémonie ; ne complétez pas des cartes illisibles et ne dupliquez pas de titres uniquement pour atteindre 98.
Préservez la progression du cinéma ancien aux films contemporains tout en permettant différents traitements visuels. Décrivez les illustrations comme des interprétations, pas des images d’archive. Notez la provenance des œuvres, personnages, typographies et bandes-son avant réutilisation.
Utilisez un terminal séparé avec Git, Node 20+, FFmpeg/ffprobe et Python 3.11–3.13 ou uv :
git clone https://github.com/lemomo-ai/lemo-opuscar.git cinema-study
cd cinema-study
export LEMO_OPUSCAR_HOME="$PWD"
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps voice
D=study/opuscar98
mkdir -p "$D/reference" "$D/evidence" "$D/out"
git rev-parse HEAD > "$D/evidence/commit.txt"
Copiez le film téléchargé dans reference/opuscar98.mp4 au sein de ce répertoire. Conservez le fichier de verrouillage et les dépendances résolues. Ces commandes de préparation ne récupèrent pas le projet promo/ non publié.
3. Donnez à Opus un brief complet de reconstruction
Le prompt de programmation ci-dessous est nouvellement écrit. Pour un projet EveryGen AI, adaptez l’extrait visuel choisi aux commandes de mouvement disponibles sur le site plutôt que de soumettre des consignes de construction externe comme si EveryGen AI était un terminal. Définissez l’ouverture, l’ordre des informations, les transitions et le temps de lecture final dans votre propre brief.
Choisissez la durée et le rapport d’image EveryGen AI avant de répartir le rythme en détail. Un projet court peut nécessiter moins d’entrées plutôt que des libellés plus rapides. La durée de la référence ne devient pas une durée EveryGen AI disponible, et un extrait condensé ne prouve pas la recréation de toute la rétrospective.
Utilisez Sketch dans EveryGen AI lorsque votre première question porte sur la composition, le placement des légendes et la hiérarchie visuelle. Utilisez Motion lorsque vous êtes prêt à examiner le minutage. Gardez la version du projet EveryGen AI acceptée avant de demander une autre proposition pour comparer les changements ultérieurs à une disposition connue plutôt qu’à un souvenir incertain de l’aperçu.
Pour une chronologie EveryGen AI, précisez la séquence souhaitée de légendes vérifiées avec le rôle des illustrations. Évitez une demande vague d’histoire cinématographique laissant le contenu factuel à l’invention. Après génération, comparez le texte EveryGen AI au relevé approuvé, y compris l’orthographe, le rattachement des années et les cartes qui se répètent ou disparaissent de façon inattendue.
Considérez l’audio comme une décision de production séparée dans l’étude EveryGen AI. Le processus animé actuel crée un projet visuel silencieux. Si du son est ajouté ailleurs, vérifiez-le selon le montage image accepté et documentez sa source ; ne décrivez pas un export EveryGen AI comme reproduisant automatiquement la bande-son de référence.
Un brief EveryGen AI utile inclut ce qui doit rester stable pendant la révision : ordre chronologique, libellés vérifiés, traitement visuel choisi et espace de lecture. Il nomme aussi le changement précis demandé. Ces consignes soutiennent l’examen mais ne remplacent pas la vérification du projet EveryGen AI obtenu à travers toutes ses cartes et transitions.
Nouveau prompt, pas la conversation originale de l’auteur :
Reconstruct the published OPUSCAR 98 case from the supplied MP4 and checked
timeline.csv. Inspect the repository commit, locks, DIRECTOR.md, TECHNIQUE.md,
core/README.md, and gallery feature-source note. The original promo/ project
is absent: do not invent its files, build commands, prompts, or model logs.
Preserve the observed chronological structure, verified years/titles, chapter
changes, and readable illustrations. Compare entries with Academy records;
flag conflicts rather than fabricating history. Keep author attribution.
Implement new source in study/opuscar98: index.html, timeline.js, chapter
modules, credits, and mix.py. Label this an independent reconstruction.
Use the installed READY/render(t)/DUR interface, absolute time, fixed seeds,
and reproducible forward/reverse seeks. Choose 24 fps for this reconstruction,
quantize cues to integer frames, and record duration separately from the
391.424-second reference container and README's 6:25 description.
Build the audio master from cleared supplied material and reviewed timings;
do not invent narration or silently substitute an uncleared soundtrack.
Keep every title, caption, image and cue linked to its evidence. Implement
mix.py to write out/mix.wav. Missing evidence/assets must be identified,
not masked. Otherwise proceed using documented core commands. Save prompts,
actual model/provider/effort/session details, changes and checks. Do not publish.
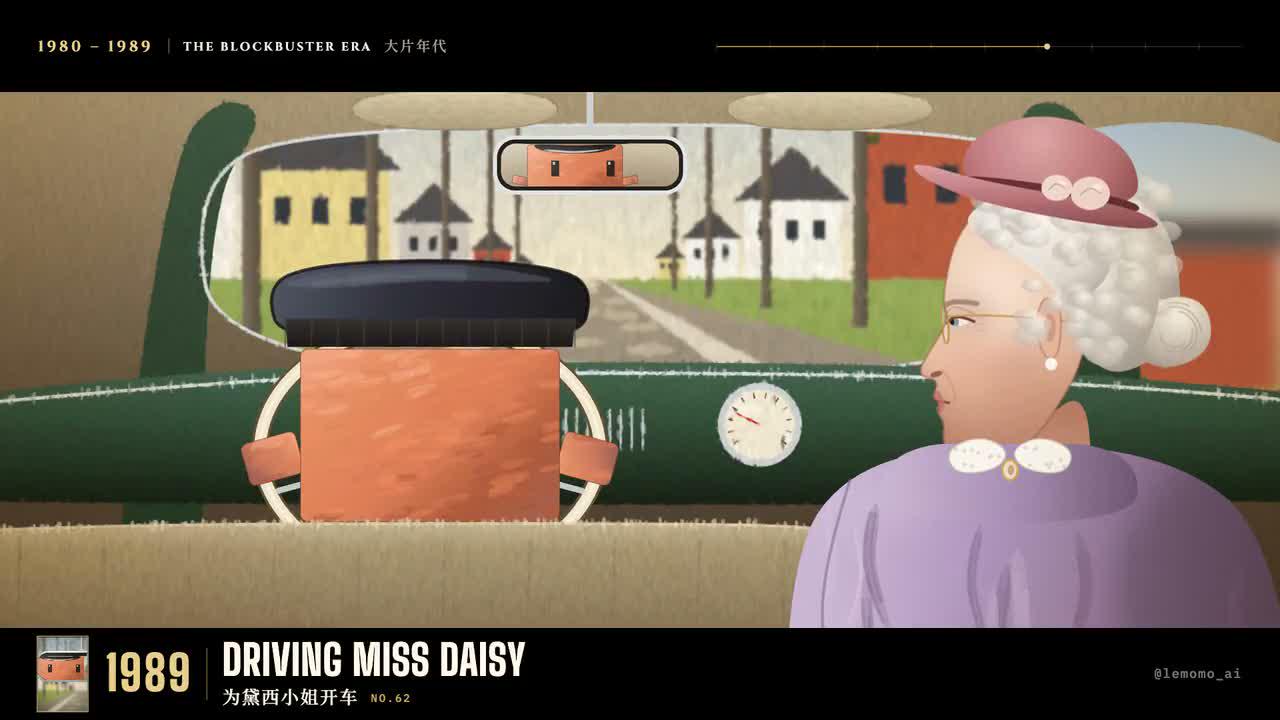
Autre image du film de l’auteur ; préservez son contexte d’année et de titre.
4. Effectuez le rendu de la reconstruction réellement implémentée
Un aperçu EveryGen AI et un rendu externe répondent à des questions de production différentes. Le premier montre le concept demandé ; le second traite une source nouvellement implémentée avec ses dépendances et ses éléments. Identifiez précisément les deux résultats et ne présentez pas une proposition EveryGen AI comme la preuve de la bonne exécution des commandes de reconstruction indépendante.
Examinez les cartes EveryGen AI pendant leurs pauses de lecture et leurs transitions. Une légende peut être correcte sur une image fixe tout en laissant trop peu de temps de lecture ou en chevauchant l’entrée suivante. Regardez d’abord la séquence EveryGen AI sans pause, puis examinez les transitions confuses pour déterminer si le problème vient du minutage, de la disposition ou du contenu factuel.
Comparez les changements de chapitre au plan EveryGen AI accepté. Une transition doit orienter le public plutôt que sauter discrètement des éléments ou associer un titre à l’illustration précédente. Utilisez le plan écrit pour situer les limites souhaitées, mais exigez que la lecture EveryGen AI communique elle-même l’ordre sans explication continue.
Pour une reconstruction locale, conservez des images échantillonnées et les métadonnées de rendu réelles comme preuves. Pour EveryGen AI, conservez les versions acceptées du projet et examinez la vidéo exportée. Ni un message de fin ni une seule belle image ne prouvent que toutes les légendes, illustrations et transitions sont restées cohérentes pendant toute la séquence finalisée.
Si l’audio ajouté ailleurs change de longueur, accordez image et son avant la transmission. Gardez la référence originale séparée pendant ce travail. L’export silencieux du projet EveryGen AI doit rester distinct d’une version montée ultérieurement, y compris les légendes, musiques et narrations réalisées dans une autre application.
Une fois la nouvelle page et le mixeur présents, utilisez les interfaces de rendu partagées de Lemo, pas un script de construction inexistant du long format :
.venv/bin/python "$D/mix.py"
node core/render/still.mjs "$D" 0 --out "$D/evidence/stills"
node core/render/video.mjs "$D" --fps 24 --workers 2 --out "$D/out/picture.mp4"
sh core/render/mux.sh "$D/out/picture.mp4" "$D/out/mix.wav" "$D/out/study.mp4" 24 0
ffprobe -v error -count_frames -show_streams -show_format -of json "$D/out/study.mp4"
ffmpeg -v error -i "$D/out/study.mp4" -f null -
Échantillonnez d’autres images aux limites de chapitres enregistrées. Vérifiez la fin complète de la bande-son avant le multiplexage : le multiplexeur partagé peut couper l’audio à la longueur de l’image.
5. Corrigez la chronologie et acceptez tout le montage
Écrivez chaque correction EveryGen AI autour d’un problème observé : titre mal orthographié, année mal associée, carte dupliquée ou pause trop courte. Gardez la chronologie acceptée explicite, puis examinez les cartes voisines après la révision. Une demande EveryGen AI de correction de légende ne garantit pas que toutes les autres illustrations ou transitions restent inchangées.
Si une erreur factuelle apparaît dans une sortie EveryGen AI, revenez au relevé vérifié avant d’éditer les mots. Un remplacement plausible ne suffit pas. Si la légende requise ne peut pas être rendue de façon fiable, simplifiez la disposition ou finalisez le texte exact ailleurs, tout en conservant l’étude visuelle EveryGen AI choisie comme version source séparée.
Rouvrez l’export final et comparez-le à la chronologie acceptée. Vérifiez le début, l’ordre des chapitres, chaque titre visible et la pause de lecture finale. Décrivez le résultat selon le travail réellement accompli, qu’il s’agisse d’une courte étude visuelle ou d’une reconstruction indépendante. Gardez visibles les questions historiques non résolues au lieu de les transformer en légendes affirmatives.
Transmettez ensemble le relevé de preuves, le projet accepté, les éléments utilisés, les notes de révision et la sortie finale. Le destinataire doit pouvoir relier chaque libellé factuel à son justificatif et distinguer le film source de votre nouveau travail. Les corrections ultérieures deviennent possibles sans devoir reconstruire votre raisonnement à partir de la seule vidéo finale.
Correct only the observed year/title, illustration, or timing mismatch.
Update linked captions and audio together. Preserve chronology and reading
holds; show the evidence, source diff, and fresh boundary frames.
Image de la publication originale, pas une preuve de reconstruction nouvellement achevée.
Comparez le nombre d’images décodées au plan d’images réel de la reconstruction, puis regardez et écoutez l’ensemble. Archivez les preuves, la source, les prompts, les versions, les retouches et le MP4. La licence du dépôt couvre son logiciel sous MIT ; elle n’autorise pas automatiquement les images de films, personnages, musiques ou autres éléments tiers.